OpenAI 应用研究负责人 Boris Power 刚刚透露了一个令同行绝望的内部真相:公司 80% 到 90% 的研究力量,根本没在管当下的产品,而是全量押注在 GPT-7、GPT-8 甚至更遥远的未来版本上。
至于市面上吵得不可开交的那些小版本升级,在 OpenAI 内部直接被归类为“极度短视”——那不过是今天为了快速吸收反馈的临时补丁,根本算不上长期正道。
这种降维打击的打法到底有多狠?答案藏在一个叫做“大师与学徒”的炼丹公式里。
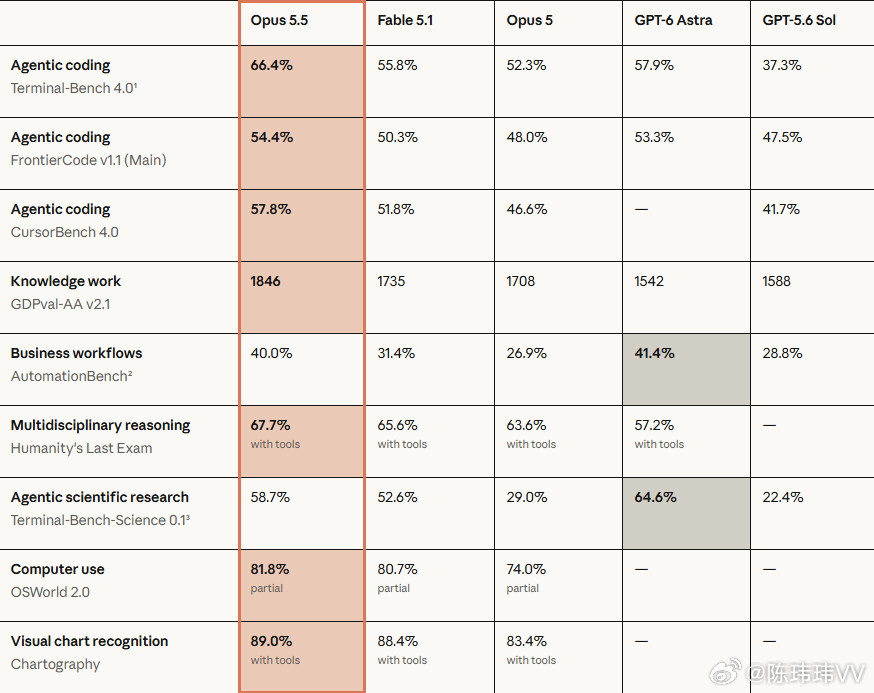
OpenAI 的真实策略是:先不计成本地砸出一尊算力怪兽、超级大师模型 Astra;然后再把 Astra 当成“名师”,通过模型蒸馏技术,降维打造出小巧精悍的“学徒模型” Luna。
这直接撕下了大模型行业最后的温情脉脉。以前大家以为开发好用的端侧小模型,靠的是算法工程师夜以继日地做架构优化、做精细化数据清洗。
结果 OpenAI 直接摊牌了:最好的小模型从来不是从小培养起来的,而是从最顶级的超级模型身上“偷”来的。这就好比普通人苦读十年,不如顶级院士直接把毕生功力一掌注入你体内。这种知识蒸馏的效率,直接把传统的小模型自训路线送进了历史博物馆。
仔细想想,这背后的逻辑挺耐人寻味的。
当全球绝大多数玩家还在为了 7B、13B 参数模型的榜单分数提升一个百分点而欢呼,或者在把大模型当“聊天打屁工具”做各种外壳包装时,OpenAI 已经在用硅谷最极致的降维打击,重新定义了这场游戏规则。那些被外界捧上天的新版本,不过是他们通往 AGI 路上的“副产品”;你以为大家在同台竞技,其实人家只是把淘汰下来的阶段性产物当作免费体验卡发给了市场。
别人在拼命卷眼前,他们在提前布局未来十年。在“超级大师教出天才学徒”的算力生态面前,单靠小打小闹的工程修补,可能连看到对方尾灯的机会都没有了。
这种降维式的“偷师”打法,不知又要让多少正埋头苦干的团队,今晚彻底睡不着觉了。