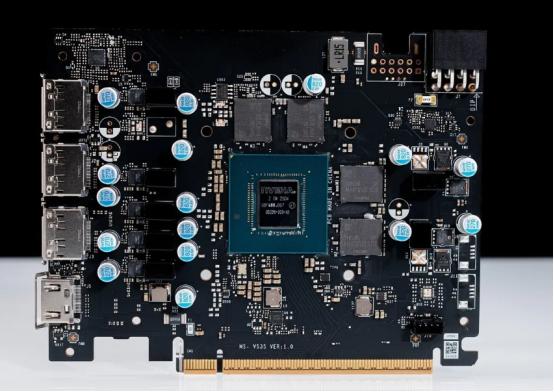
有人会问,为什么不把英伟达显卡拆了研究,再照着造出国产显卡?说白了,就算零件全摆在眼前,也未必能看懂,更别说造出来。
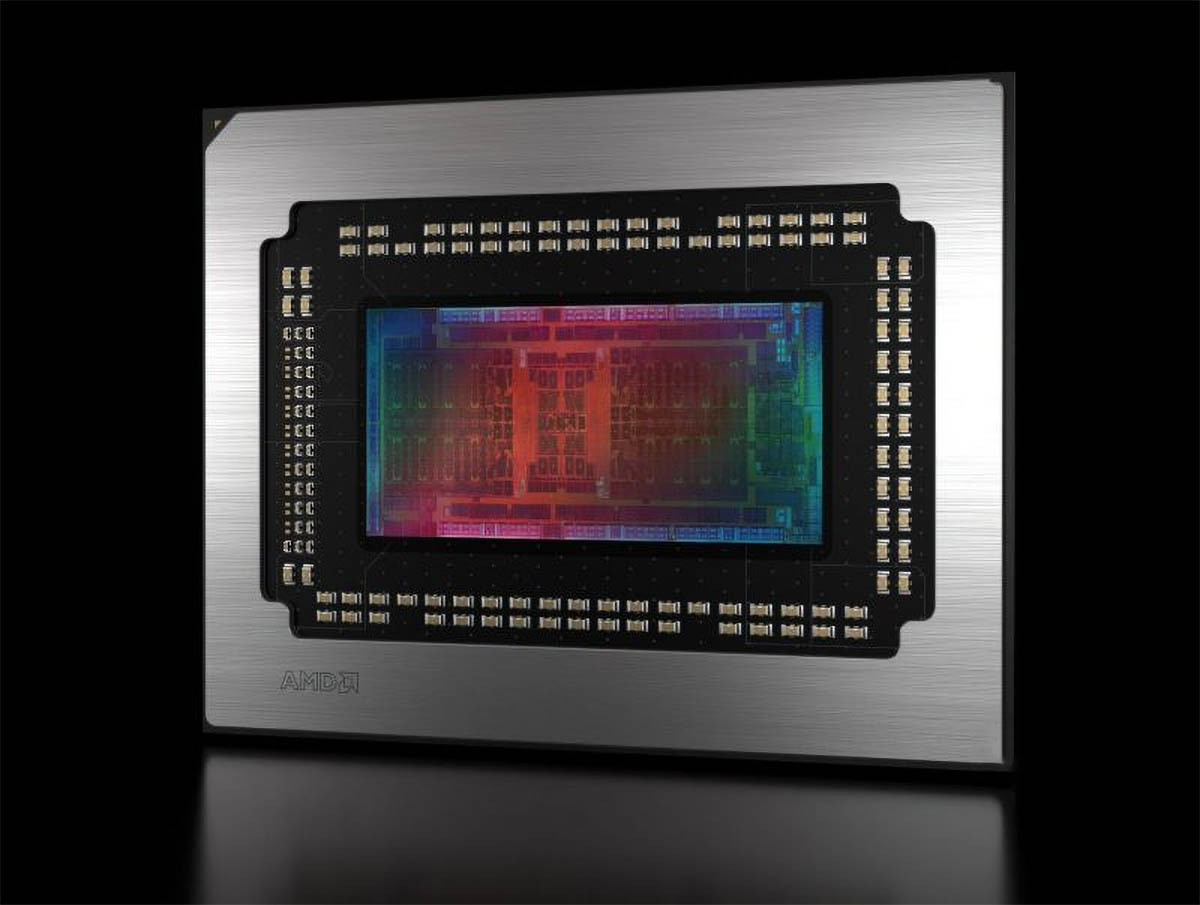
一块高端GPU摆在实验室里,外壳、电路板、供电模块、显存颗粒和接口布局都能分析,芯片经过处理后,内部结构也能分层观察,但看见结构不等于掌握设计。
真正难的,是弄明白数百亿个晶体管为什么这样排列,又如何共同完成计算、调度、缓存、通信和功耗控制。
拿英伟达H100来说,它采用台积电定制的4N工艺,集成约800亿个晶体管,到了Blackwell架构,晶体管数量更是达到2080亿个,已经不是靠显微镜“看图识字”能搞定的东西。
即使把每一层线路拍得清清楚楚,得到的也只是芯片最终长什么样,却不知道设计团队为何这样取舍,更拿不到源代码、验证模型、工艺参数和故障处理逻辑。
这就像拿到一座超级工厂的完整航拍图,能够看清厂房和道路,却不知道每条生产线怎么运转,机器参数如何设定,出了故障又该怎样处理。
逆向分析当然有价值,它能帮助工程师了解封装方案、接口设计和产品思路,但要靠拆解直接复制一颗高端GPU,基本不具备现实意义。
因为芯片还不是画出线路就能生产,它必须经过设计、验证、流片、封装和测试,任何环节出现一点偏差,轻则性能下降,重则整批晶圆报废。
芯片制造需要沉积、光刻、刻蚀、离子注入等数百道工序,部分结构要反复叠加近百层,而且每一层都得以纳米级精度对准,光有一台先进光刻机远远不够。
光刻胶、掩模版、刻蚀设备、检测仪器、工艺配方和洁净生产线,缺少任何关键一环,都可能影响良率,更别说稳定量产和控制成本。
高端GPU还离不开先进封装,它需要把计算芯片、封装基板和HBM高带宽内存高密度连接起来,同时解决供电、散热、信号完整性等一连串问题。
所以,拆开一张显卡,和建成一条能够长期交付高性能芯片的产业链,中间隔着的不是一张设计图,而是无数设备、材料、人才和经验积累。
更难跨越的,其实还是软件。
英伟达真正厉害的地方,不只是一颗颗GPU,而是从2006年开始持续建设的CUDA平台,它把编译器、驱动、算法库、开发工具和各类行业软件绑成了一整套体系。
截至2025年,英伟达披露其平台开发者已超过600万,CUDA-X拥有400多个加速库,这意味着开发者遇到问题时,能找到工具、案例和成熟方案。
国产GPU即使某项参数追平英伟达,如果驱动不稳定,常用框架不好适配,程序迁移成本过高,用户照样不会大规模使用,这才是生态壁垒最棘手的地方。
还有一个不能忽略的问题,那就是知识产权,GPU架构、芯片布图、互联方式和软件技术涉及大量专利,直接照搬即使做得出来,也很难堂堂正正进入商业市场。
这笔账怎么算都不划算,花几年时间复制别人上一代产品,等到样品出来,对方的新架构可能已经上市,与其永远追着旧答案跑,不如建立自己的技术路线。
中国走的正是这条路,摩尔线程、壁仞科技等企业持续推进自主GPU,国内也在补齐EDA工具、制造设备、关键材料、先进封装和软件适配等环节。
2025年7月上线的人工智能“焕新社区”,已经汇聚超过2000卡规模的国产算力、244个行业模型和近160个行业数据集,这种从算力到应用的联合适配,比拆开一张显卡更有产业价值。
中国还有庞大的制造业和应用市场,云计算、智能汽车、工业仿真、数字孪生等场景都能为国产GPU提供真实需求,只要产品进入使用,就能不断发现问题、持续迭代。
我认为,国产替代真正要比拼的,不是谁能把英伟达拆得最碎,而是谁能把自主架构、制造工艺、先进封装和软件生态连成一条线。
拆解可以用来学习,却不能代替创新,追赶高端GPU没有一夜翻盘的捷径,但中国拥有完整产业门类、巨大市场和持续投入能力,沿着自主路线一步步推进,才是最稳也最有后劲的办法。