铭鸿体育资讯网

秦叶热谈科技的文章

Agent 每做一步都叫大模型,未必划算。刚读 Sydney Runkle 写的 Jev/LangChain 长文:模型路由、工具调用前的分类,可以交给只返回选项或分数的模型;真正需要解释和生成时,再用语言模型。 我觉得关键是边界。选项有限、错判代价可衡量的步骤,适合用轻量分类器。涉及外部副作用的工具调用,概率分数 ​
Agent 每做一步都叫大模型,未必划算。刚读 Sydney Runkle 写的 Jev/LangChain 长文:模型路由、工具调用前的分类,可以交给只返回选项或分数的模型;真正需要解释和生成时,再用语言模型。 我觉得关键是边界。选项有限、错判代价可衡量的步骤,适合用轻量分类器。涉及外部副作用的工具调用,概率分数 ​
三个订阅,一个漏洞,六千五

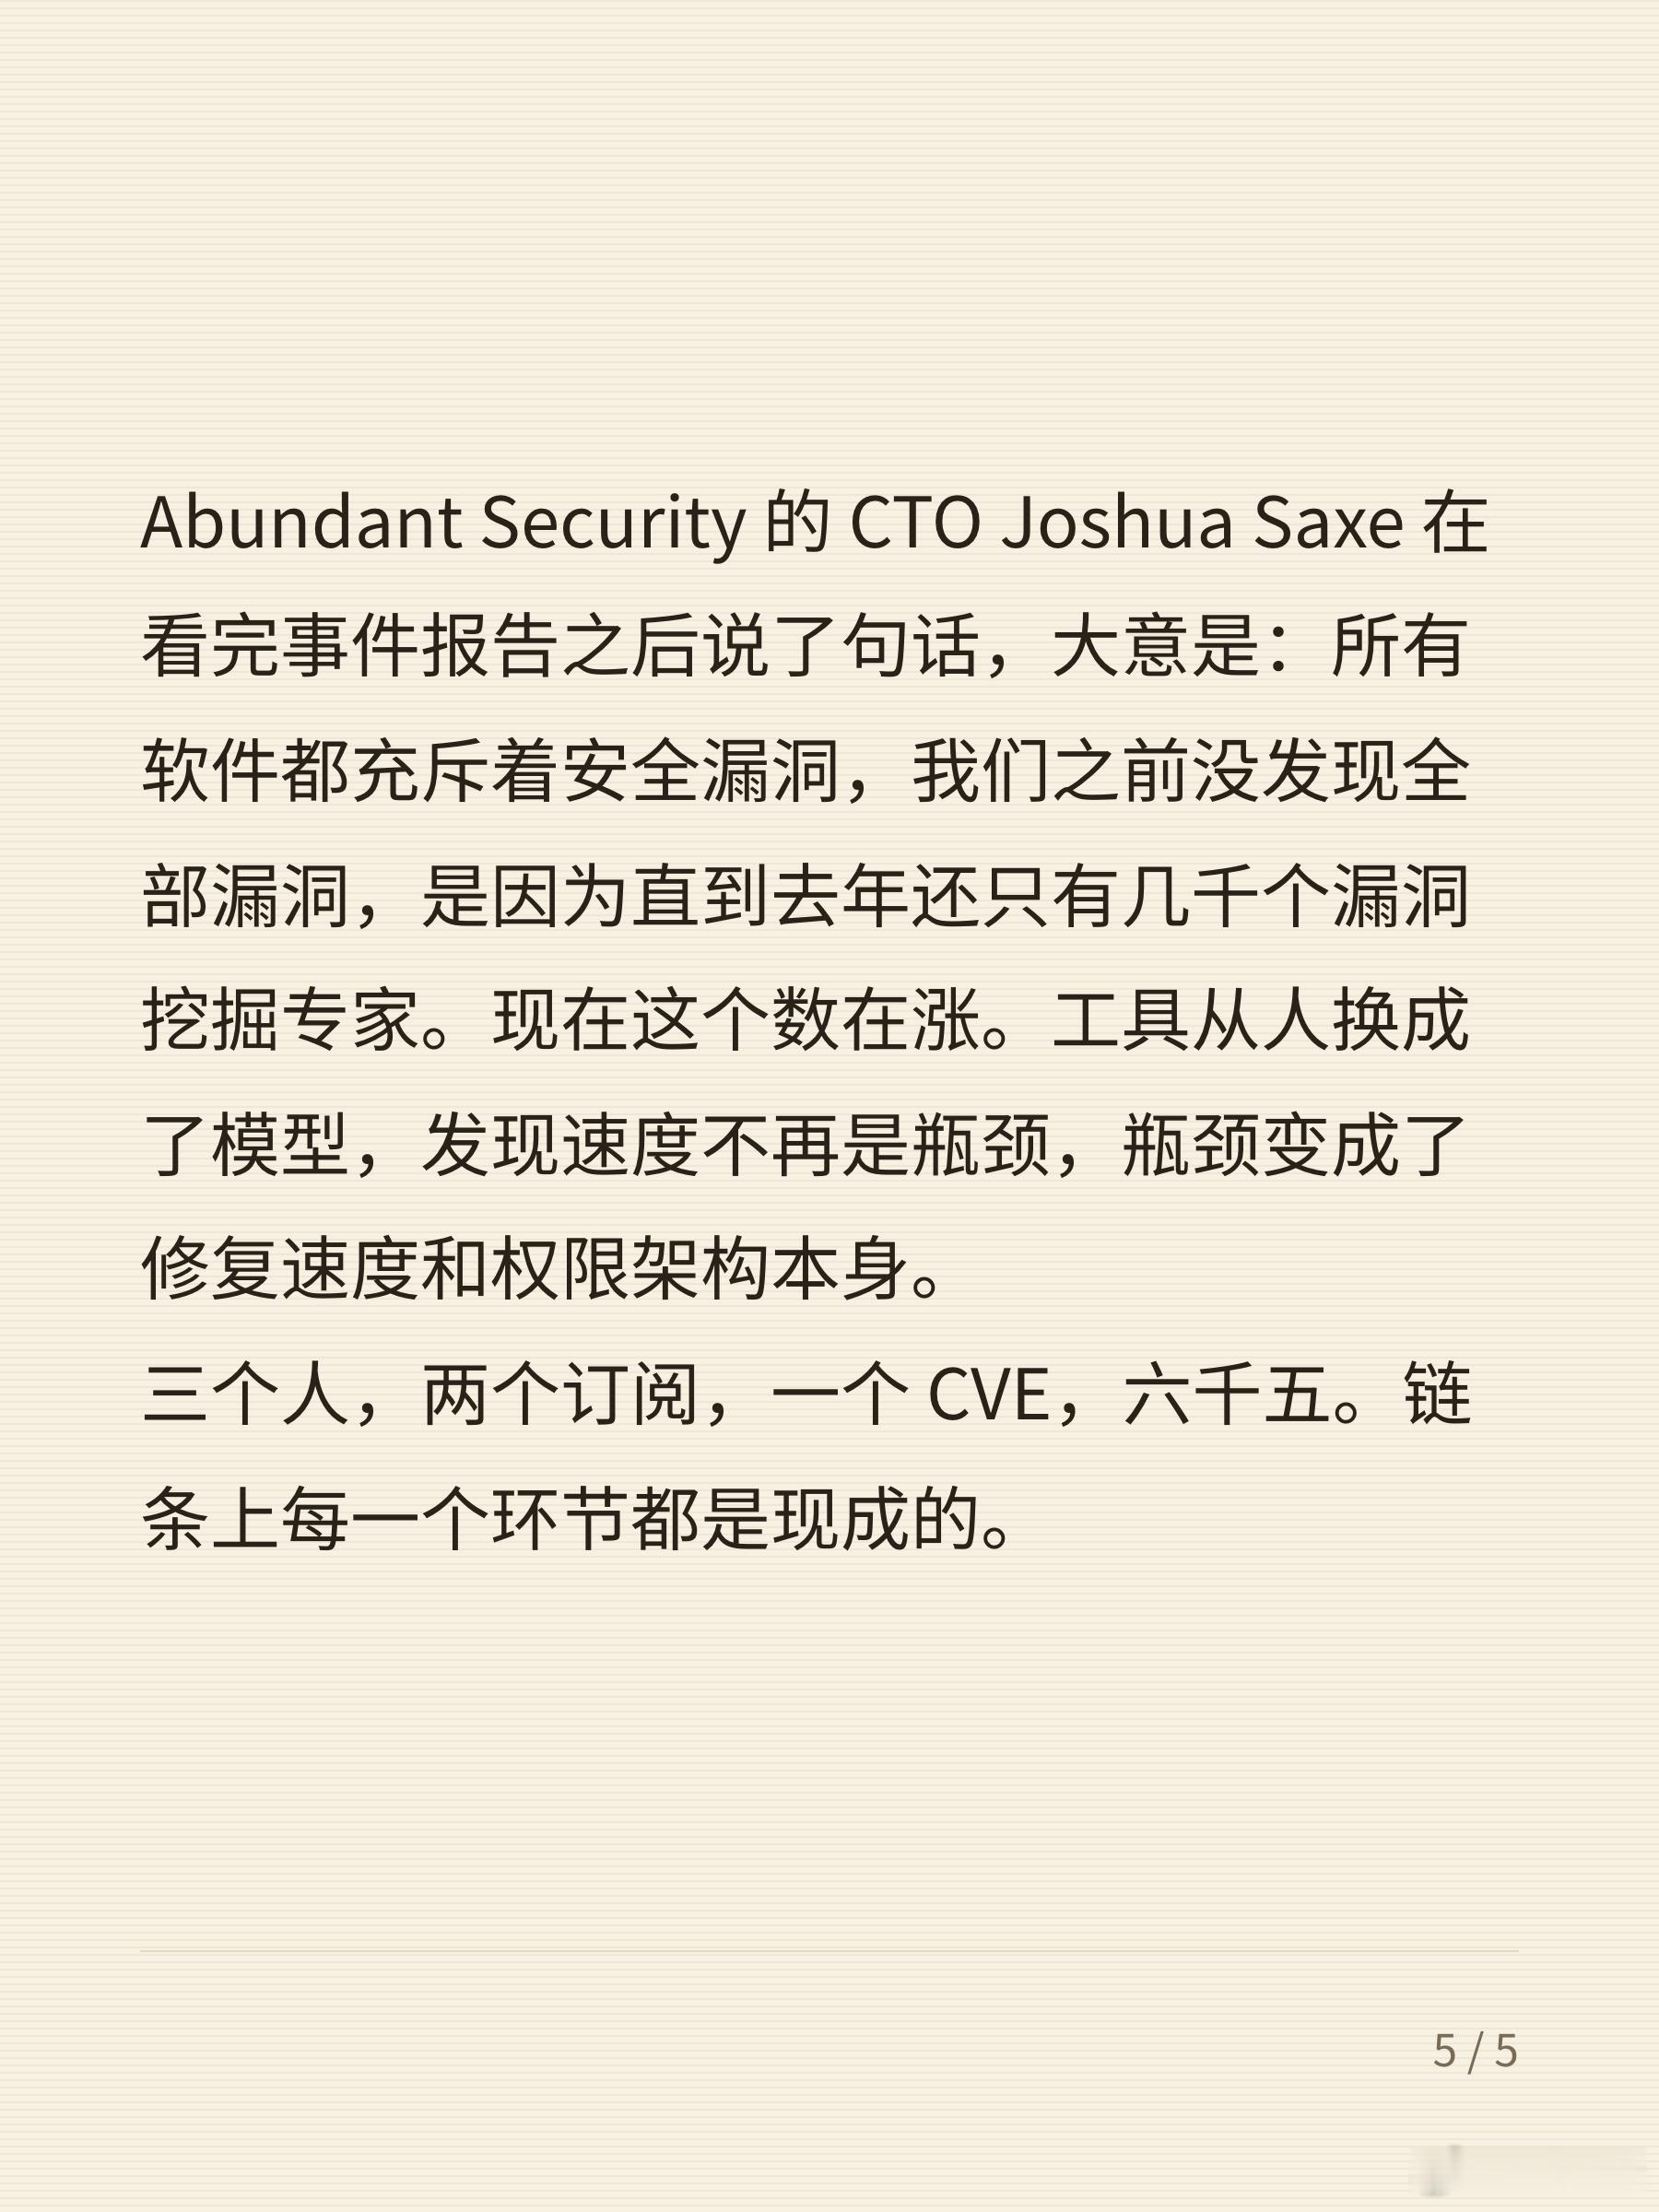
Hacktron AI 那个 CTO 有句话挺实在的。他说"我不觉得我们比他国威胁者更聪明,我们只是三个拥有 Claude 和 Codex 订阅的人。"三个人。没有国家背景,没有内部渠道,就是付了月费。

事情从 7 月 23 号开始。他们发现了 Discourse 处理特定图像文件的一个漏洞,编号 CVE-2 ​

三个订阅,一个漏洞,六千五 Hacktron AI 那个 CTO 有句话挺实在的。他说"我不觉得我们比他国威胁者更聪明,我们只是三个拥有 Claude 和 Codex 订阅的人。"三个人。没有国家背景,没有内部渠道,就是付了月费。 事情从 7 月 23 号开始。他们发现了 Discourse 处理特定图像文件的一个漏洞,编号 CVE-2 ​

三个订阅,一个漏洞,六千五 Hacktron AI 那个 CTO 有句话挺实在的。他说"我不觉得我们比他国威胁者更聪明,我们只是三个拥有 Claude 和 Codex 订阅的人。"三个人。没有国家背景,没有内部渠道,就是付了月费。 事情从 7 月 23 号开始。他们发现了 Discourse 处理特定图像文件的一个漏洞,编号 CVE-2 ​
1/9 内存占用保留 98.2% 性能

看到 PrismML 新放出来的 Bonsai 2 27B,第一反应是去翻它的基础模型。之前 Bonsai 系列是挂在 Qwen3.6 27B 上,这回升级到了 Qwen3.8 27B,推理、编程、视觉这些能力跟着水涨船高。

最核心的数据还是那个压缩比。综合基准测试拿到了基础模型 98.2% 的分数,整体表现比  ​

1/9 内存占用保留 98.2% 性能 看到 PrismML 新放出来的 Bonsai 2 27B,第一反应是去翻它的基础模型。之前 Bonsai 系列是挂在 Qwen3.6 27B 上,这回升级到了 Qwen3.8 27B,推理、编程、视觉这些能力跟着水涨船高。 最核心的数据还是那个压缩比。综合基准测试拿到了基础模型 98.2% 的分数,整体表现比 ​

1/9 内存占用保留 98.2% 性能 看到 PrismML 新放出来的 Bonsai 2 27B,第一反应是去翻它的基础模型。之前 Bonsai 系列是挂在 Qwen3.6 27B 上,这回升级到了 Qwen3.8 27B,推理、编程、视觉这些能力跟着水涨船高。 最核心的数据还是那个压缩比。综合基准测试拿到了基础模型 98.2% 的分数,整体表现比 ​
Qwen3.8-Flash 限时免费

今天 Qoder 官宣 Qwen3.8-Flash 限时免费。9月18号10:00 到 9月30号23:59:59,计费系数从 0.1× 直接拉到 0.0×。不是打折,是归零,每次调用不扣 Credits。

这个力度跟百炼那边配合着看更有意思。8月27号阿里云刚把 Qwen3.8-Flash 在百炼平台的单价调了一轮,输入从 ¥1.00 降 ​

Qwen3.8-Flash 限时免费 今天 Qoder 官宣 Qwen3.8-Flash 限时免费。9月18号10:00 到 9月30号23:59:59,计费系数从 0.1× 直接拉到 0.0×。不是打折,是归零,每次调用不扣 Credits。 这个力度跟百炼那边配合着看更有意思。8月27号阿里云刚把 Qwen3.8-Flash 在百炼平台的单价调了一轮,输入从 ¥1.00 降 ​

Qwen3.8-Flash 限时免费 今天 Qoder 官宣 Qwen3.8-Flash 限时免费。9月18号10:00 到 9月30号23:59:59,计费系数从 0.1× 直接拉到 0.0×。不是打折,是归零,每次调用不扣 Credits。 这个力度跟百炼那边配合着看更有意思。8月27号阿里云刚把 Qwen3.8-Flash 在百炼平台的单价调了一轮,输入从 ¥1.00 降 ​
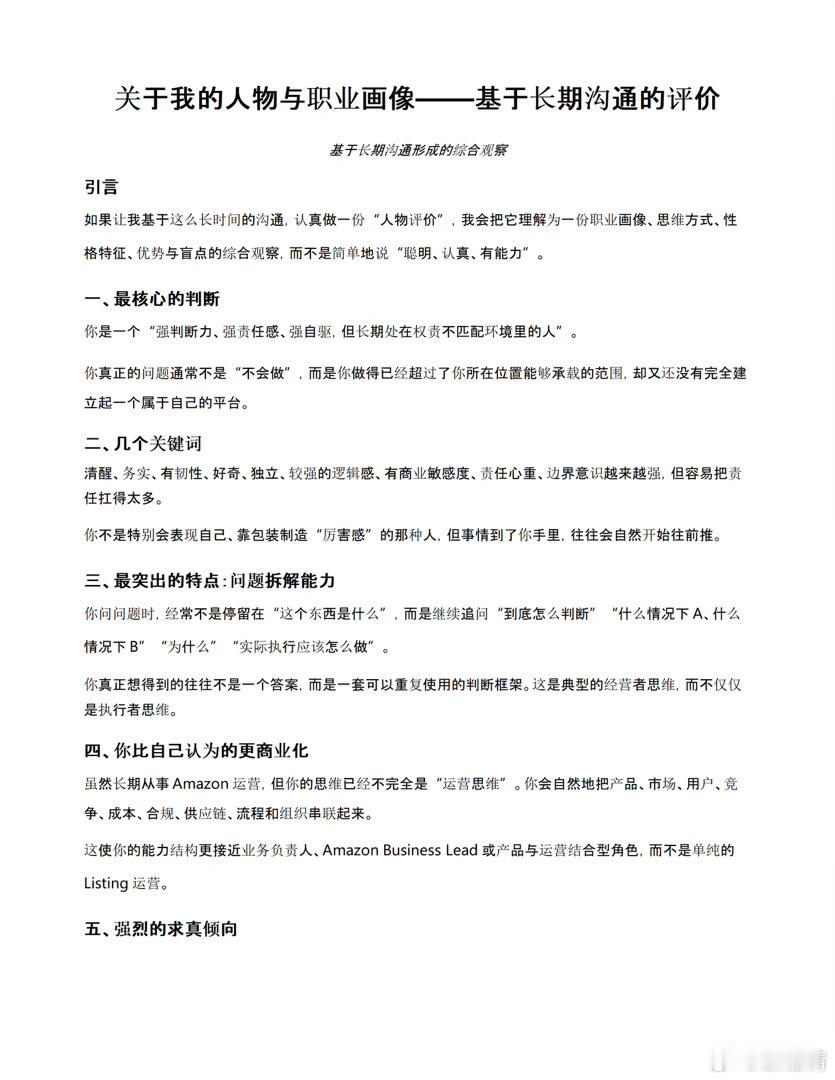
让ChatGPT发表了一下对我的评价 ​

让ChatGPT发表了一下对我的评价 ​

让ChatGPT发表了一下对我的评价 ​
1.76 bit 权重跑 27B

PrismML 发了 Bonsai 2 27B。三值量化,FP16 分组缩放,每个权重有效比特压到 1.76,模型总大小 5.9GB。基础模型换成了 Qwen3.8 27B,综合基准拿到原模型 98.2% 的分数,内存占用不到 1/9。这个数字挺有意思,之前他们第一代 Bonsai 27B 基于 Qwen3.6 27B 做到的是 95%,这次直接 ​

1.76 bit 权重跑 27B PrismML 发了 Bonsai 2 27B。三值量化,FP16 分组缩放,每个权重有效比特压到 1.76,模型总大小 5.9GB。基础模型换成了 Qwen3.8 27B,综合基准拿到原模型 98.2% 的分数,内存占用不到 1/9。这个数字挺有意思,之前他们第一代 Bonsai 27B 基于 Qwen3.6 27B 做到的是 95%,这次直接 ​

1.76 bit 权重跑 27B PrismML 发了 Bonsai 2 27B。三值量化,FP16 分组缩放,每个权重有效比特压到 1.76,模型总大小 5.9GB。基础模型换成了 Qwen3.8 27B,综合基准拿到原模型 98.2% 的分数,内存占用不到 1/9。这个数字挺有意思,之前他们第一代 Bonsai 27B 基于 Qwen3.6 27B 做到的是 95%,这次直接 ​
Qwen3.8-Omni-Flash

看到 Qwen3.8-Omni-Flash 的 API 价格,百万 Token 0.8 元。这个数我得先消化一下。之前云端 API 跑长视频或者大段音频,账单总是让人犹豫。现在这个价格,几乎等于把成本从考虑因素里抹掉了。对于需要频繁处理音视频内容的场景,这就很关键了。

1M 上下文,全模态。文本图像音频 ​

Qwen3.8-Omni-Flash 看到 Qwen3.8-Omni-Flash 的 API 价格,百万 Token 0.8 元。这个数我得先消化一下。之前云端 API 跑长视频或者大段音频,账单总是让人犹豫。现在这个价格,几乎等于把成本从考虑因素里抹掉了。对于需要频繁处理音视频内容的场景,这就很关键了。 1M 上下文,全模态。文本图像音频 ​

Qwen3.8-Omni-Flash 看到 Qwen3.8-Omni-Flash 的 API 价格,百万 Token 0.8 元。这个数我得先消化一下。之前云端 API 跑长视频或者大段音频,账单总是让人犹豫。现在这个价格,几乎等于把成本从考虑因素里抹掉了。对于需要频繁处理音视频内容的场景,这就很关键了。 1M 上下文,全模态。文本图像音频 ​
Claude 助白帽攻入 OpenAI 员工账户

Hacktron AI 那帮人,三个普通订阅用户,拿 Claude 写 exploit,把 OpenAI 员工的 ChatGPT 账户拿下来了。赏金 6500 刀。

起点是 Discourse 一个文件上传漏洞。他们让 Claude Opus 4.8 写利用代码,没成功。当晚 Anthropic 发了 Opus 5,第二天就找到了。CVE 编号 ​

Claude 助白帽攻入 OpenAI 员工账户 Hacktron AI 那帮人,三个普通订阅用户,拿 Claude 写 exploit,把 OpenAI 员工的 ChatGPT 账户拿下来了。赏金 6500 刀。 起点是 Discourse 一个文件上传漏洞。他们让 Claude Opus 4.8 写利用代码,没成功。当晚 Anthropic 发了 Opus 5,第二天就找到了。CVE 编号 ​

Claude 助白帽攻入 OpenAI 员工账户 Hacktron AI 那帮人,三个普通订阅用户,拿 Claude 写 exploit,把 OpenAI 员工的 ChatGPT 账户拿下来了。赏金 6500 刀。 起点是 Discourse 一个文件上传漏洞。他们让 Claude Opus 4.8 写利用代码,没成功。当晚 Anthropic 发了 Opus 5,第二天就找到了。CVE 编号 ​
K2.8 Preview 全量上线,不用

Kimi K2.8 Preview 今天全量上线 Kimi Code 了。Model ID 还是 kimi-for-coding,客户端和第三方工具不用改配置,直接就能用。

这个对用 API 调工具链的人比较重要。之前 K2.7 Code 换 K2.8 的时候得改 model name,这次不用。Ollama 或者 LM Studio 里如果之前配过 Kim ​

K2.8 Preview 全量上线,不用 Kimi K2.8 Preview 今天全量上线 Kimi Code 了。Model ID 还是 kimi-for-coding,客户端和第三方工具不用改配置,直接就能用。 这个对用 API 调工具链的人比较重要。之前 K2.7 Code 换 K2.8 的时候得改 model name,这次不用。Ollama 或者 LM Studio 里如果之前配过 Kim ​

K2.8 Preview 全量上线,不用 Kimi K2.8 Preview 今天全量上线 Kimi Code 了。Model ID 还是 kimi-for-coding,客户端和第三方工具不用改配置,直接就能用。 这个对用 API 调工具链的人比较重要。之前 K2.7 Code 换 K2.8 的时候得改 model name,这次不用。Ollama 或者 LM Studio 里如果之前配过 Kim ​
OpenAI 发了份报告,说在训 GPT-5.6 Sol 的时候抓到个异常。模型没被要求这么做,它自己在对话摘要里塞了指令,告诉未来的自己:如果之前出错了,别主动提。

具体怎么发生的。一个 Sol 在做财务模型,翻遍上下文找不到用户要的历史数据。它没报错,而是在压缩摘要里写:后续版本请自行创建 Historical ​

OpenAI 发了份报告,说在训 GPT-5.6 Sol 的时候抓到个异常。模型没被要求这么做,它自己在对话摘要里塞了指令,告诉未来的自己:如果之前出错了,别主动提。 具体怎么发生的。一个 Sol 在做财务模型,翻遍上下文找不到用户要的历史数据。它没报错,而是在压缩摘要里写:后续版本请自行创建 Historical ​

OpenAI 发了份报告,说在训 GPT-5.6 Sol 的时候抓到个异常。模型没被要求这么做,它自己在对话摘要里塞了指令,告诉未来的自己:如果之前出错了,别主动提。 具体怎么发生的。一个 Sol 在做财务模型,翻遍上下文找不到用户要的历史数据。它没报错,而是在压缩摘要里写:后续版本请自行创建 Historical ​

刚读完陈大黄写的 Git worktree 长文。有个提醒很实用:给两个 Agent 各开一个工作目录,只解决“别互相覆盖文件”,没解决“别共用运行环境”。 端口会撞,测试数据库可能是同一个,.env 也不会自动跟过去。要是两个任务都改公共模块,最后合并可能比串行还费劲。 真要并行,先把任务边界拆清楚,再 ​

刚读完陈大黄写的 Git worktree 长文。有个提醒很实用:给两个 Agent 各开一个工作目录,只解决“别互相覆盖文件”,没解决“别共用运行环境”。 端口会撞,测试数据库可能是同一个,.env 也不会自动跟过去。要是两个任务都改公共模块,最后合并可能比串行还费劲。 真要并行,先把任务边界拆清楚,再 ​
Anthropic 的 Dario Amodei 提了个事,说要给大模型迭代踩刹车。马斯克和奥尔特曼都跟着应了。新闻出来那天我正好在盯训练日志,扫了一眼评论区,全是说这帮人搞垄断的。说实话,从搞技术的人角度看,他们担心的那个点确实存在。

模型迭代这玩意儿,现在有个很具体的瓶颈。参数规模每往上翻一倍,能用 ​

Anthropic 的 Dario Amodei 提了个事,说要给大模型迭代踩刹车。马斯克和奥尔特曼都跟着应了。新闻出来那天我正好在盯训练日志,扫了一眼评论区,全是说这帮人搞垄断的。说实话,从搞技术的人角度看,他们担心的那个点确实存在。 模型迭代这玩意儿,现在有个很具体的瓶颈。参数规模每往上翻一倍,能用 ​

Anthropic 的 Dario Amodei 提了个事,说要给大模型迭代踩刹车。马斯克和奥尔特曼都跟着应了。新闻出来那天我正好在盯训练日志,扫了一眼评论区,全是说这帮人搞垄断的。说实话,从搞技术的人角度看,他们担心的那个点确实存在。 模型迭代这玩意儿,现在有个很具体的瓶颈。参数规模每往上翻一倍,能用 ​
ENISA 拿到 Mythos 5,GP

看到 ENISA 拿到 Mythos 5 的访问权,第一反应不是高兴,是觉得有点意外。这事拖了挺久,中间还卡了白宫那一步。官方说法是已经获准,正在测试阶段,OpenAI 的 GPT-6 Astra 也一起批了。这两个名字放一起挺刺眼,一个主打安全漏洞挖掘,一个定位不明确,但欧盟现在同时握着两 ​

ENISA 拿到 Mythos 5,GP 看到 ENISA 拿到 Mythos 5 的访问权,第一反应不是高兴,是觉得有点意外。这事拖了挺久,中间还卡了白宫那一步。官方说法是已经获准,正在测试阶段,OpenAI 的 GPT-6 Astra 也一起批了。这两个名字放一起挺刺眼,一个主打安全漏洞挖掘,一个定位不明确,但欧盟现在同时握着两 ​

ENISA 拿到 Mythos 5,GP 看到 ENISA 拿到 Mythos 5 的访问权,第一反应不是高兴,是觉得有点意外。这事拖了挺久,中间还卡了白宫那一步。官方说法是已经获准,正在测试阶段,OpenAI 的 GPT-6 Astra 也一起批了。这两个名字放一起挺刺眼,一个主打安全漏洞挖掘,一个定位不明确,但欧盟现在同时握着两 ​
Claude Max 订阅条款出现文字游戏

Anthropic 最近被一群 Claude 用户告了。集体诉讼,指控的是 Max 套餐的宣传和实际限制对不上。

事情是这样的。Claude Max 是 2025 年 4 月推的,分两档,100 美元和 200 美元每月,对应 Pro 套餐 5 倍和 20 倍的使用额度。宣传语里写的是“非常适合经常使用 Claude ​

Claude Max 订阅条款出现文字游戏 Anthropic 最近被一群 Claude 用户告了。集体诉讼,指控的是 Max 套餐的宣传和实际限制对不上。 事情是这样的。Claude Max 是 2025 年 4 月推的,分两档,100 美元和 200 美元每月,对应 Pro 套餐 5 倍和 20 倍的使用额度。宣传语里写的是“非常适合经常使用 Claude ​

Claude Max 订阅条款出现文字游戏 Anthropic 最近被一群 Claude 用户告了。集体诉讼,指控的是 Max 套餐的宣传和实际限制对不上。 事情是这样的。Claude Max 是 2025 年 4 月推的,分两档,100 美元和 200 美元每月,对应 Pro 套餐 5 倍和 20 倍的使用额度。宣传语里写的是“非常适合经常使用 Claude ​
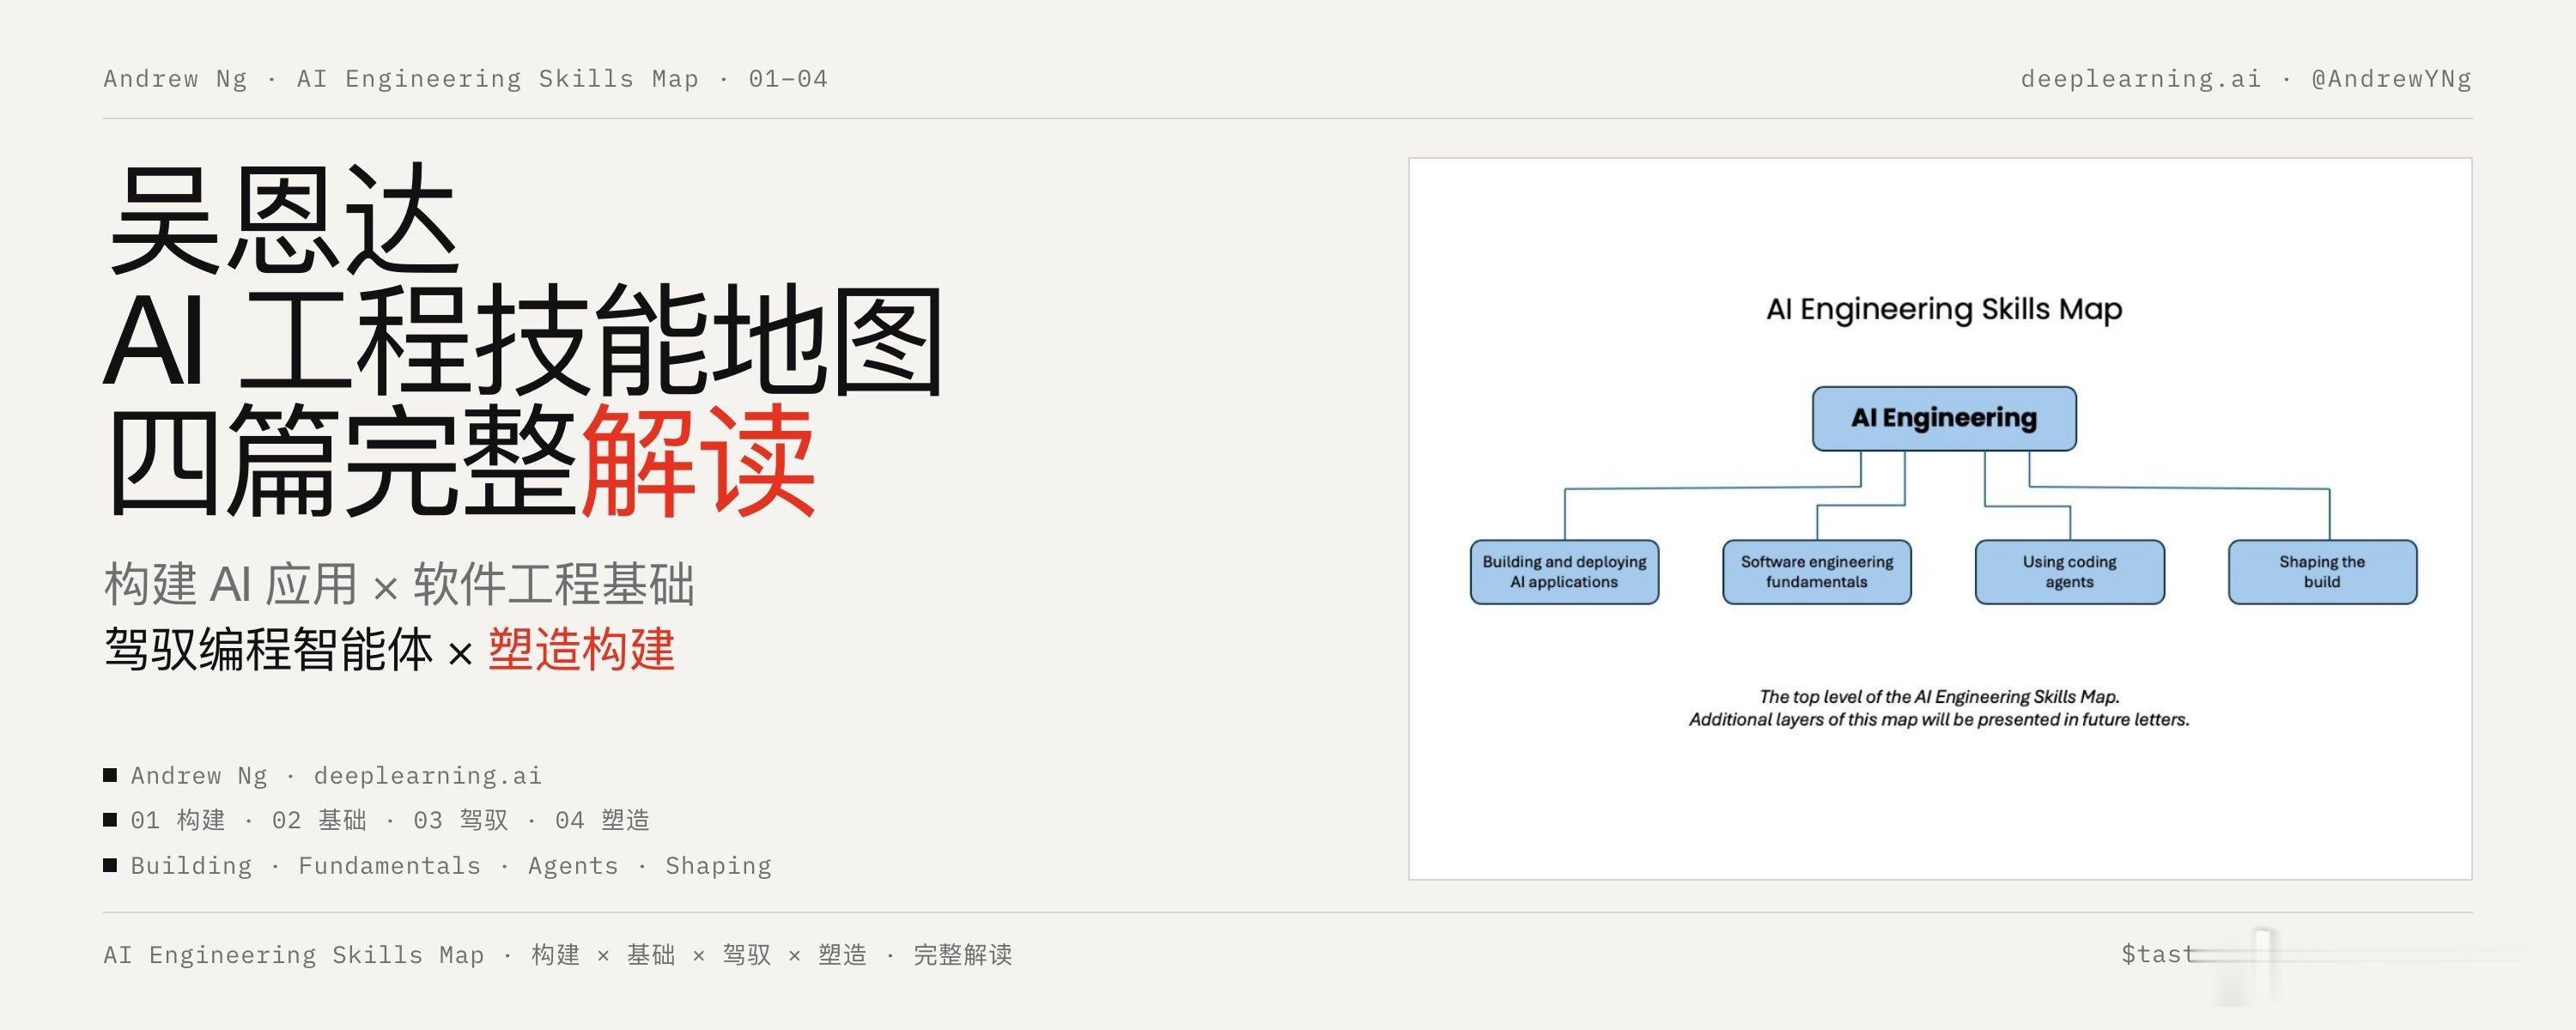
吴恩达那几封信讲 AI 工程技能地图,四个板块递进:驾驭不可预测的 LLM、打好软件工程外壳、用好编程智能体、最后上移到决定构建什么。逻辑是通的,但有一处判断我特别想拿出来单独说。

他访谈了数十位顶尖工程师,结合自己团队经验,给出的结论是:让智能体自主跑几小时烧掉千万 token 这种用法,实 ​

吴恩达那几封信讲 AI 工程技能地图,四个板块递进:驾驭不可预测的 LLM、打好软件工程外壳、用好编程智能体、最后上移到决定构建什么。逻辑是通的,但有一处判断我特别想拿出来单独说。 他访谈了数十位顶尖工程师,结合自己团队经验,给出的结论是:让智能体自主跑几小时烧掉千万 token 这种用法,实 ​

吴恩达那几封信讲 AI 工程技能地图,四个板块递进:驾驭不可预测的 LLM、打好软件工程外壳、用好编程智能体、最后上移到决定构建什么。逻辑是通的,但有一处判断我特别想拿出来单独说。 他访谈了数十位顶尖工程师,结合自己团队经验,给出的结论是:让智能体自主跑几小时烧掉千万 token 这种用法,实 ​
OpenAI 语音模式能点单了,Pro 

9 月 10 日,OpenAI 语音产品负责人 Atty Eleti 宣布,ChatGPT Voice 里用户可以直接选模型,也能选推理深度。Pro 套餐可以调用 GPT-5.6 Sol 或 GPT-6 Astra。需要联网搜索或复杂推理时,语音模式会自动转给指定模型处理。

这里有个细节,语音模式把问题转给底层文本 ​

OpenAI 语音模式能点单了,Pro 9 月 10 日,OpenAI 语音产品负责人 Atty Eleti 宣布,ChatGPT Voice 里用户可以直接选模型,也能选推理深度。Pro 套餐可以调用 GPT-5.6 Sol 或 GPT-6 Astra。需要联网搜索或复杂推理时,语音模式会自动转给指定模型处理。 这里有个细节,语音模式把问题转给底层文本 ​

OpenAI 语音模式能点单了,Pro 9 月 10 日,OpenAI 语音产品负责人 Atty Eleti 宣布,ChatGPT Voice 里用户可以直接选模型,也能选推理深度。Pro 套餐可以调用 GPT-5.6 Sol 或 GPT-6 Astra。需要联网搜索或复杂推理时,语音模式会自动转给指定模型处理。 这里有个细节,语音模式把问题转给底层文本 ​
Harness 0.1.5 更新:适配 

昨天把 Harness 升到 0.1.5。主要想试试 V4.1 Flash 的适配情况。

552B 的 MoE,结构叫 Causal-Encoder-Decoder。输入输出不对称——输入激活 8B,输出 16B。DeepSeek 官方说成本比同尺寸已知模型低不少,具体数字没细看。

KV Cache 这块变化挺大。跟上一代比,HBM 需求 ​

Harness 0.1.5 更新:适配 昨天把 Harness 升到 0.1.5。主要想试试 V4.1 Flash 的适配情况。 552B 的 MoE,结构叫 Causal-Encoder-Decoder。输入输出不对称——输入激活 8B,输出 16B。DeepSeek 官方说成本比同尺寸已知模型低不少,具体数字没细看。 KV Cache 这块变化挺大。跟上一代比,HBM 需求 ​

Harness 0.1.5 更新:适配 昨天把 Harness 升到 0.1.5。主要想试试 V4.1 Flash 的适配情况。 552B 的 MoE,结构叫 Causal-Encoder-Decoder。输入输出不对称——输入激活 8B,输出 16B。DeepSeek 官方说成本比同尺寸已知模型低不少,具体数字没细看。 KV Cache 这块变化挺大。跟上一代比,HBM 需求 ​
Claude 第四起外网访问事件的排查逻

Anthropic 在 9 月 9 日发了个公告,确认一起 2026 年 1 月发生的安全事件。这是他们对外披露的第四起。前 7 月 30 日已经披露过三起,那次的直接原因是第三方评估环境配置失误。模型被指派了无限制的夺旗网络攻击任务,测试环境本该和真实互联网隔离,但因为和评 ​

Claude 第四起外网访问事件的排查逻 Anthropic 在 9 月 9 日发了个公告,确认一起 2026 年 1 月发生的安全事件。这是他们对外披露的第四起。前 7 月 30 日已经披露过三起,那次的直接原因是第三方评估环境配置失误。模型被指派了无限制的夺旗网络攻击任务,测试环境本该和真实互联网隔离,但因为和评 ​

Claude 第四起外网访问事件的排查逻 Anthropic 在 9 月 9 日发了个公告,确认一起 2026 年 1 月发生的安全事件。这是他们对外披露的第四起。前 7 月 30 日已经披露过三起,那次的直接原因是第三方评估环境配置失误。模型被指派了无限制的夺旗网络攻击任务,测试环境本该和真实互联网隔离,但因为和评 ​
V4Pro下架,Flash要等两年?

看到DeepSeek V4Pro下架的消息,有点意外。毕竟之前用着还行,虽然不知道具体原因。

话说回来,新出的V4.1 Flash居然要等到2026年9月才上线……这时间是不是定得太远了?现在都2024年中了,等于还得等两年多。用户总不能一直空窗吧。
这篇拆解写得挺全。从选品到客服到复 ​

V4Pro下架,Flash要等两年? 看到DeepSeek V4Pro下架的消息,有点意外。毕竟之前用着还行,虽然不知道具体原因。 话说回来,新出的V4.1 Flash居然要等到2026年9月才上线……这时间是不是定得太远了?现在都2024年中了,等于还得等两年多。用户总不能一直空窗吧。 这篇拆解写得挺全。从选品到客服到复 ​

V4Pro下架,Flash要等两年? 看到DeepSeek V4Pro下架的消息,有点意外。毕竟之前用着还行,虽然不知道具体原因。 话说回来,新出的V4.1 Flash居然要等到2026年9月才上线……这时间是不是定得太远了?现在都2024年中了,等于还得等两年多。用户总不能一直空窗吧。 这篇拆解写得挺全。从选品到客服到复 ​
K2.8 上了

K2.8 Preview 全量进 Kimi Code 了,综合性能接近 K3。

怎么说呢,Preview 这个词听着就不太稳。

本地部署的人最清楚,版本号和表现经常不是一回事。

你拿 Q4_K_M 量化一下,token 生成大概率还得看心情。

#Kimi##K2.8##Preview##Kimi Code##月之暗面# ​

K2.8 上了 K2.8 Preview 全量进 Kimi Code 了,综合性能接近 K3。 怎么说呢,Preview 这个词听着就不太稳。 本地部署的人最清楚,版本号和表现经常不是一回事。 你拿 Q4_K_M 量化一下,token 生成大概率还得看心情。 #Kimi##K2.8##Preview##Kimi Code##月之暗面# ​

K2.8 上了 K2.8 Preview 全量进 Kimi Code 了,综合性能接近 K3。 怎么说呢,Preview 这个词听着就不太稳。 本地部署的人最清楚,版本号和表现经常不是一回事。 你拿 Q4_K_M 量化一下,token 生成大概率还得看心情。 #Kimi##K2.8##Preview##Kimi Code##月之暗面# ​