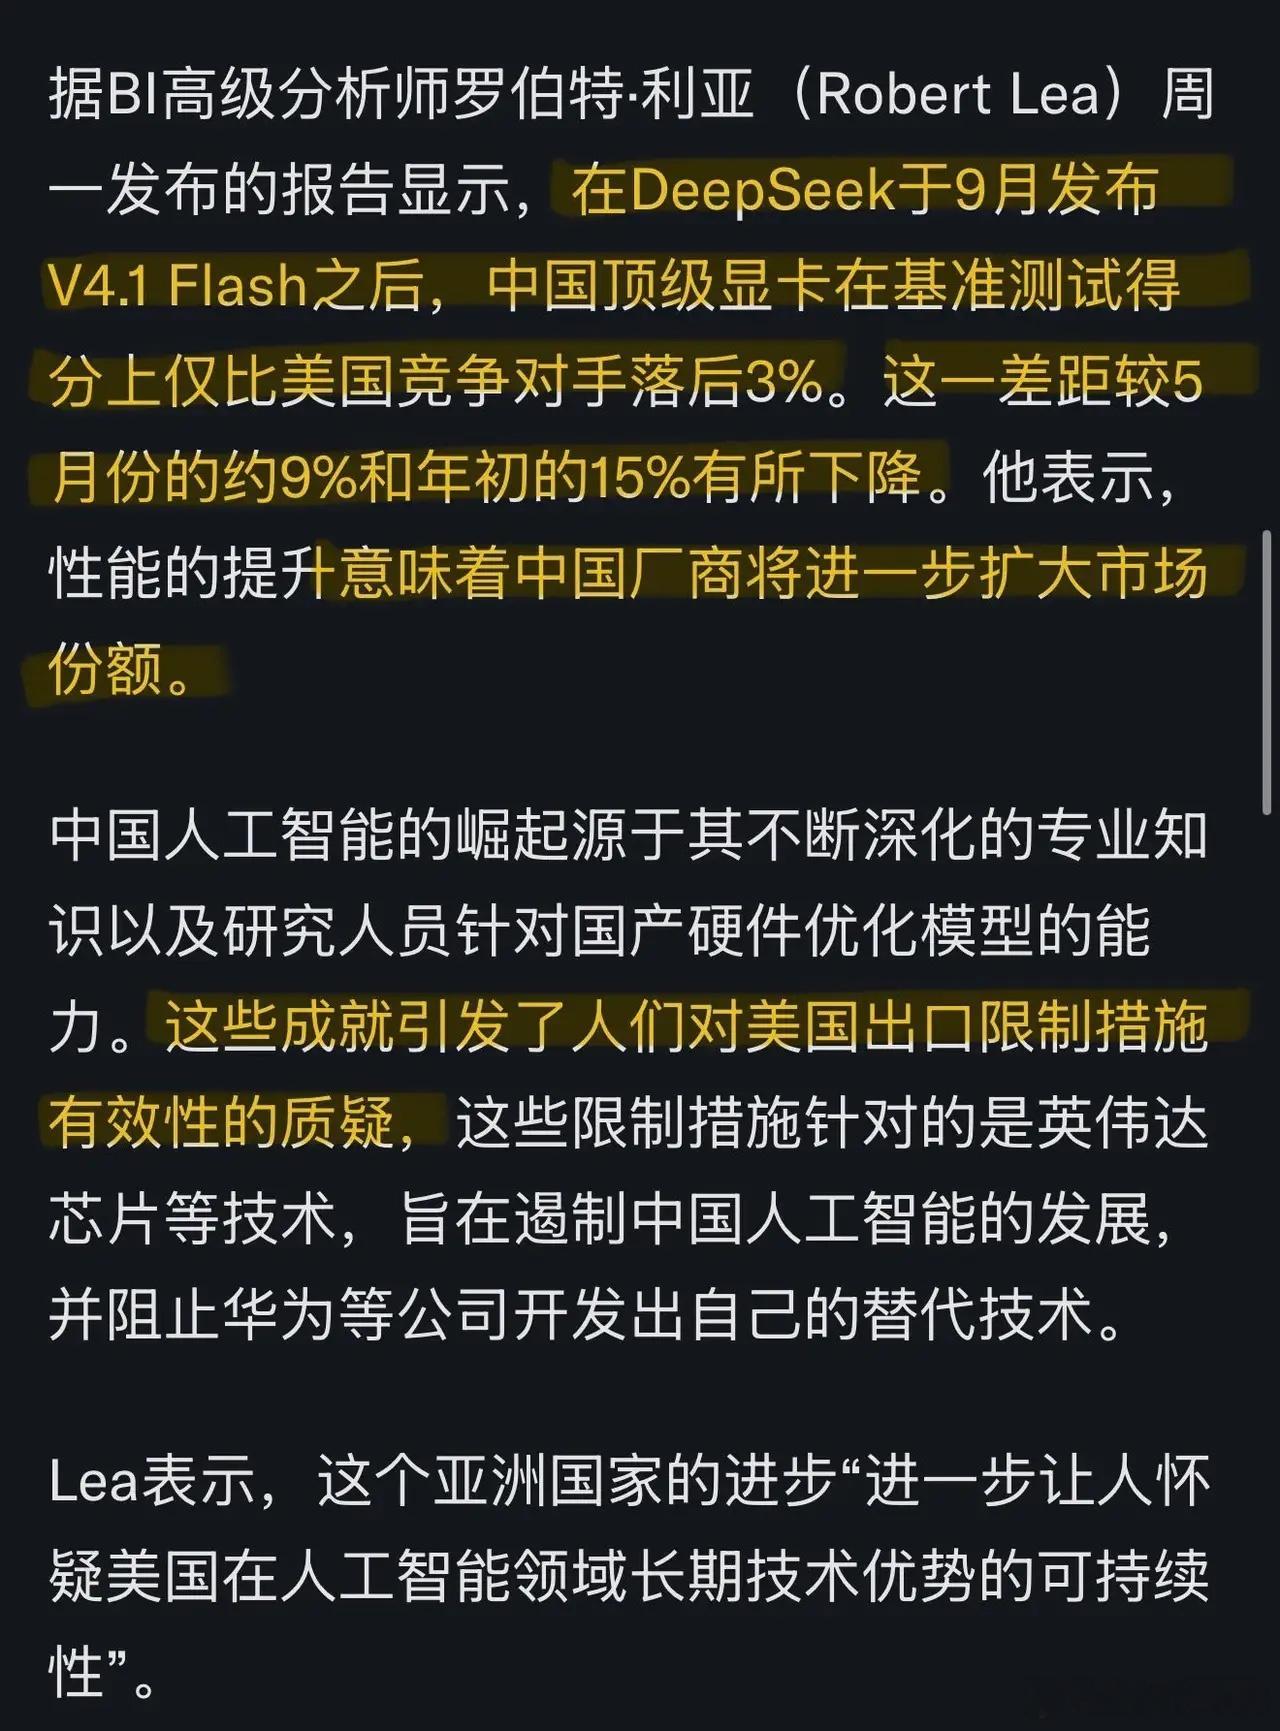
干得漂亮!中国与美国差距进一步缩小!10月5日,彭博行业研究放了一份报告。结论很直接:中美顶尖AI模型的基准测试得分差距,已经缩到了3%。
年初这个数字是15%,5月是9%,现在3%,三个月缩了6个百分点。
彭博分析师罗伯特·利亚的原话是,中国取得的进展“进一步让人质疑美国在AI领域的科技主导地位能否长期维持”。
让这个数字落地的是一个具体的模型。
DeepSeek 9月发布的V4.1 Flash,在LiveBench上拿了81.1分,美国那边最高的Anthropic,83.4分,差2.3分,按百分比算,3%。
利亚的判断是,DeepSeek的表现已经“可以与Anthropic、OpenAI的领先AI系统相媲美”。
可这份报告里有一句话,比“3%”更值得多看两眼。
利亚指出,中国AI的崛起,驱动力之一是“研究人员针对国产硬件进行模型优化”。
这话放在芯片出口管制层层加码的背景下,意思就很清楚了。
拿不到最先进的算力,就把手里的算力用到极致,不是绕过限制,是在限制里把自己逼出了另一种能力。
不过报告也有清醒的提醒,尽管得分差距缩到3%,LiveBench前15个模型里,中国只占3席。
一个模型追到3%,和一个体系追到3%,中间还隔着很远。
用盖茨9月说过的话来对照——根据不同的衡量方式,中美各有至少四家机构的模型处于最先进梯队,得分最高的和另外七个之间“差距并不大”。
盖茨没说的是,在“最先进梯队”之外,美国还有多少模型在排队。
真正能看出趋势的,可能不是跑分,是调用量。
截至10月4日当周,OpenRouter平台上的数据是:中国模型处理了约57.46万亿词元,美国模型约16.2万亿。
中国是美国的3.5倍,这已经是连续第23周中国模型的周调用量超过美国。
跑分看的是天花板有多高,调用量看的是有多少人真的在用。
57万亿对16万亿,这个比例说明的事情很朴素——在开发者日常调用的场景里,中国模型已经成了默认选项之一。
DeepSeek一家占了OpenRouter上文本请求的21.8%,Hugging Face的数据更直接:过去一年,中国模型占平台下载量的41%,超过美国。
这里面有一个很实际的逻辑,瑞银的报告显示,约60%的企业已经开始为Token开支设限。
旗舰模型能力最强,但贵,日常任务不需要每次都调用最强的,中国主流模型的API价格是国际同行的五分之一到十分之一。
企业算账算下来,大量中低复杂度的活儿自然就流向了更便宜的那一边,这不是情怀,是成本。
不过把话说回来,跑分追近了,调用量上去了,不等于这场竞赛就翻篇了。
彭博报告里还有一句提醒:中国AI行业可能要到2030年才能实现盈利。
国内市场上有一千一百多个大语言模型在互相厮杀,价格战打得激烈,企业挤在利润率很薄的模型调用业务里,谁都很难建立稳固的竞争优势,技术追赶上来了,商业上能不能跑通,是另一道题。
还有一个动态变化,利亚在报告里专门说了,这类排名具有“动态变化特征”,意思是,今天差3%,明天可能拉回去,也可能继续缩。
一个模型的发布就能让数字跳动,真正的判断标准不是某一次跑分,是这种缩小的趋势能不能持续,以及差距缩小之后,商业上能不能变成可持续的东西。
年初差15%,现在差3%,这六个月的变化是真实的,但前15个模型里中国还是只占3个,这个数字也没动。
有些东西在变,有些东西还在等。