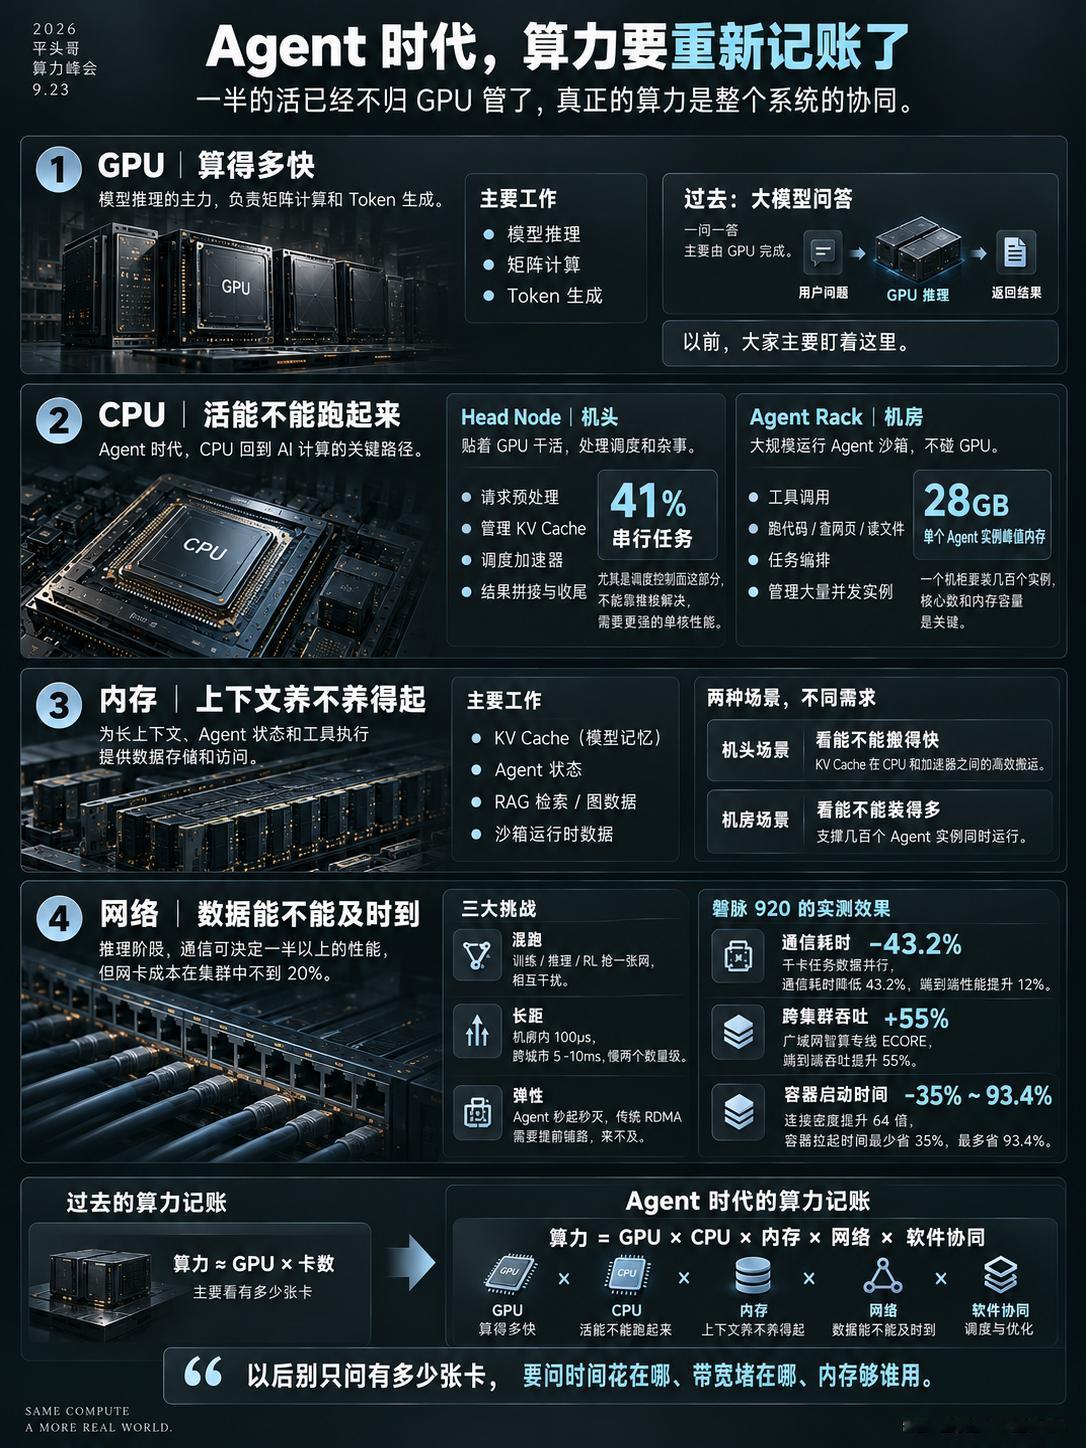
平头哥算力峰会,我在现场听完两场演讲,一场CPU,一场网卡。回来的路上想明白一件事,两场演讲的主角都不是GPU,讲的却都是GPU之外的仗。
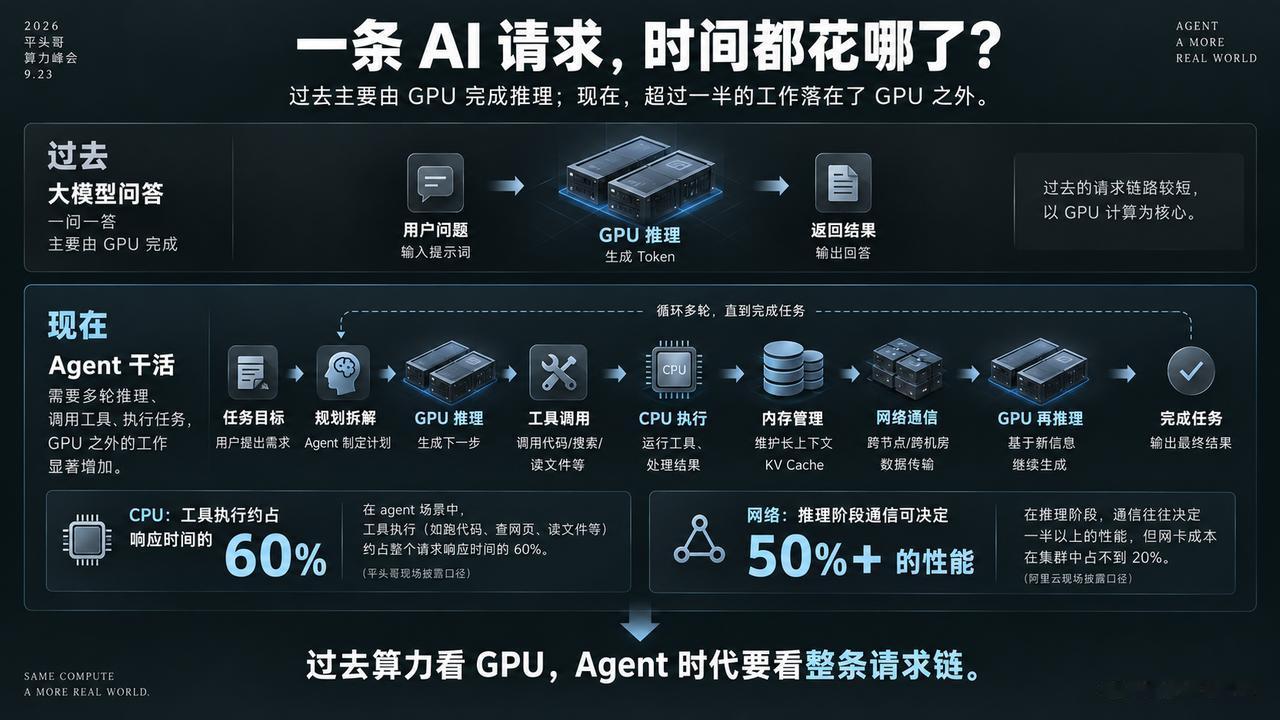
先说CPU。以前大模型一问一答,活儿基本是GPU扛。现在跑agent,它得不停循环,推理一步、调个工具、看一眼结果、再走下一步。
调工具、管上下文,全是CPU的活,现场给的数,编码 agent 场景里 CPU 这边要占五成多,它重新回到了 AI 计算的关键路径。
演讲里有个分法我印象很深,他把CPU的活儿分两类。一类贴着GPU干,叫机头,像司机带了个副驾,请求进来先归它预处理,机头慢一步,按小时烧钱的GPU就空等一步。
另一类跟推理脱钩,一个机柜塞几百个沙箱,每个沙箱里一个agent在干活,全不碰GPU。一句话,机头看内存,看能不能搬得快;机房看内存,看能不能装得多。
再说网卡。主讲人一上来先算账,到了推理阶段,往往是通信决定一半以上的性能,可网卡成本在集群里占不到两成。投入产出比最高的一项,是大家最不回头看第二眼的小板子。
他要对付的麻烦有三件,训练推理混跑互相干扰、推理拆两段后数据要跑长途、agent 的容器说来就来等不起铺路。
他报的那张卡叫磐脉920,400G带宽,网卡里内置了一块交换机,自研协议加标准协议两套并行,老集群不用拆了重建,一张一张换就行,业务不停。现场成绩单,千卡训练的数据并行通信耗时降四成多,跨集群吞吐提55%,容器拉起时间最多省九成。
两个过半放一起挺有意思,CPU 那个过半,量的是时间;通信那个过半,量的是性能。合起来就一句话,模型有多聪明,比GPU,agent 把活干得多利索,比的是CPU、内存、网络这些地基。
卡多不等于活好,这个账,行业刚开始认真算。