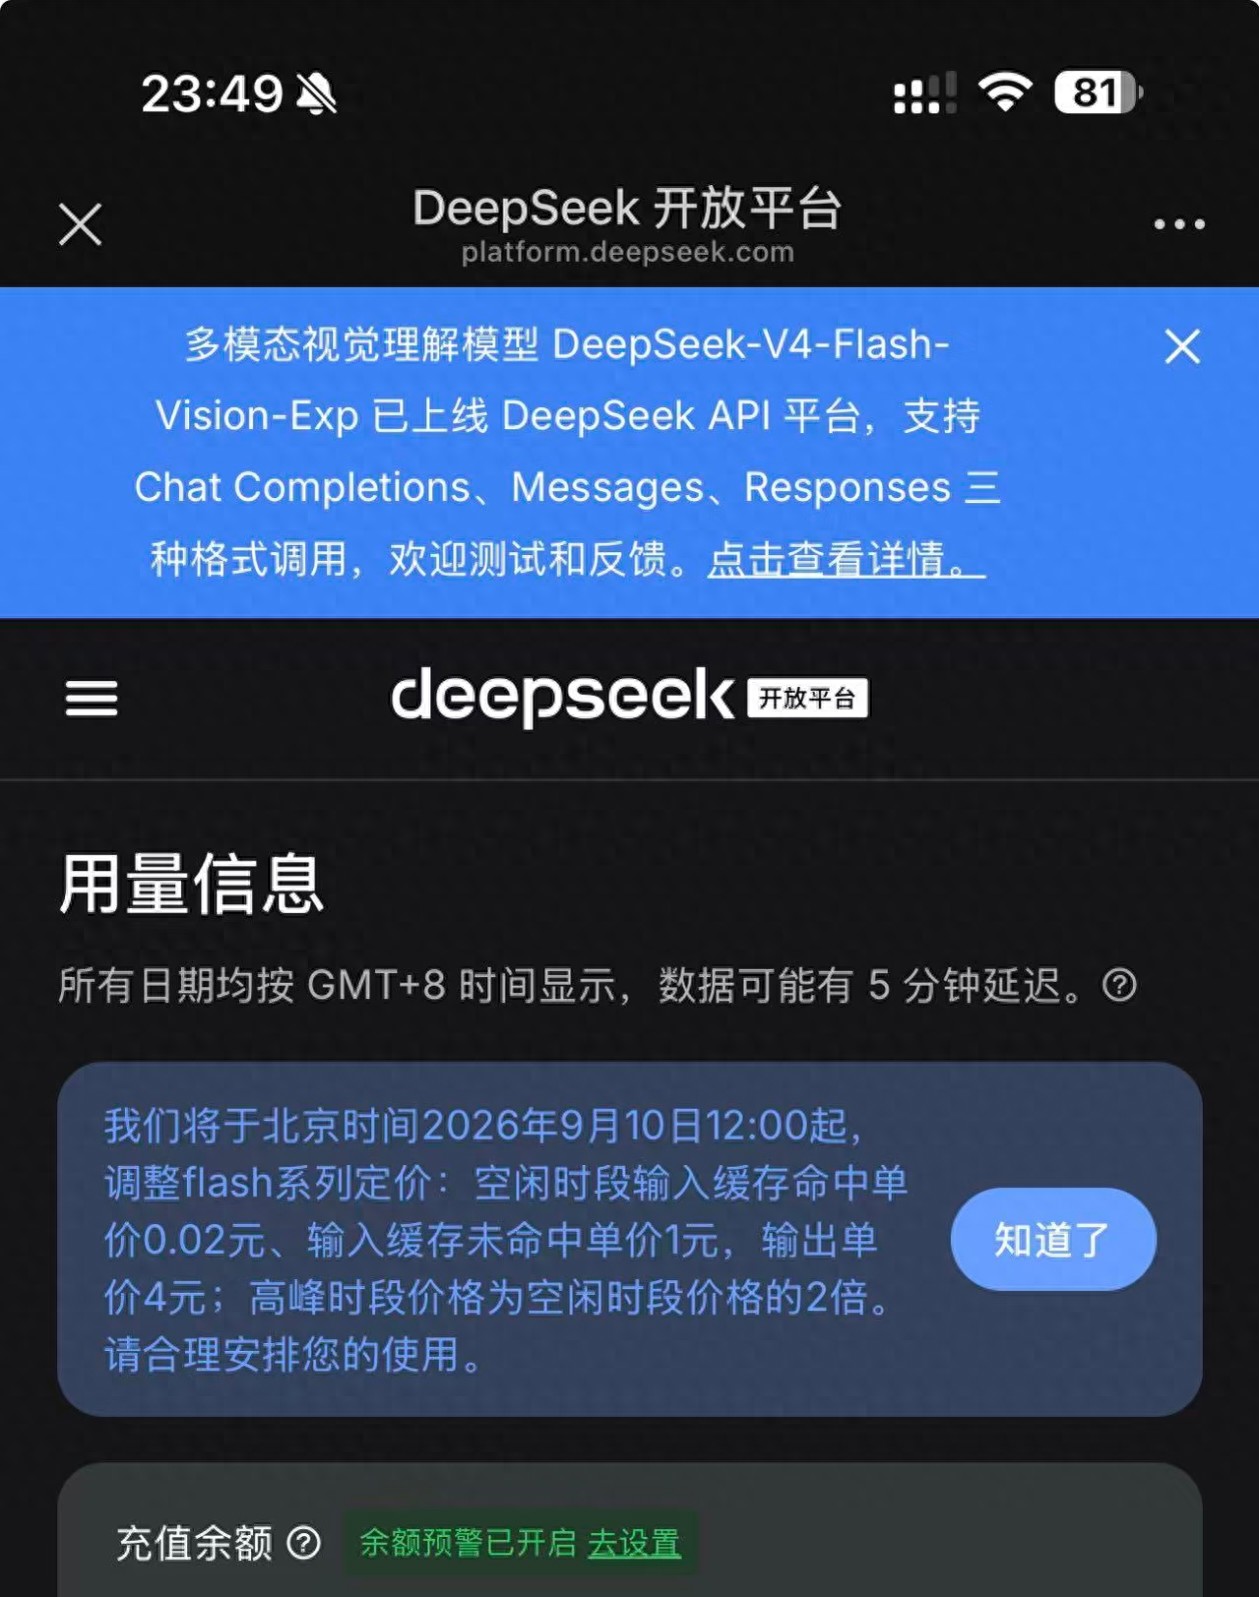
9月8日,DeepSeek在开启 V4.1 Flash 内测的同时,又公布了一轮API价格调整。新价格将从北京时间9月10日12:00起执行,Flash系列的调用成本将进一步下降。
具体来看,闲时每百万Token价格将从此前的:
输入(缓存未命中):1.5元 → 1元,降幅约33%
输出:4.5元 → 4元,降幅约11%
输入(缓存命中):0.05元 → 0.02元,降幅60%
高峰时段则按照闲时价格的2倍计费,也就是输入未命中2元、输出8元、缓存命中0.04元/百万Token。DeepSeek官方目前采用峰谷分时定价,工作日9:00-12:00、14:00-18:00为高峰时段,其余时间为闲时。
这轮降价放在DeepSeek最近几个月的动作里看,尤其有意思。
因为就在8月17日,DeepSeek才正式引入峰谷定价,并大幅上调V4系列API价格。当时V4Flash闲时输入未命中为1.5元、输出4.5元;高峰时段直接翻倍。
没想到不到一个月,价格又往下打。
而这次降价,恰好和一个新模型的出现撞在了一起。
今天DeepSeek开启了V4.1 Flash中间版本内测。这个版本采用新的模型结构,并首次原生支持多模态。官方给出的定位也很直接:能力更强、速度更快、成本更低。目前开发者不需要修改API地址,只需要把模型名称改成:
deepseek-v4.1-flash-expires-on-0910
就可以直接调用。不过需要注意,这还不是正式版。
从模型名称里的"expires-on-0910"就能看出来,它是一个限时测试版本,9月10日自动过期。目前每个账号最多20路并发,远低于正式版V4 Flash的2500路,因此更适合开发者测试和体验,而不是直接拿来承载大规模线上业务。
但从测试反馈来看,这个版本的速度已经相当夸张。有开发者实测输出速度超过300 tokens/s,最高甚至达到507 tokens/s。
所以这次真正值得关注的,可能不只是"又降了几毛钱"。
过去几个月,AI模型的价格战已经从单纯的低价竞争,开始转向能力、速度和成本一起卷。
DeepSeek现在明显在测试一件事:能不能用更便宜、更快的Flash模型,去承担过去只有Pro级模型才能完成的任务。
如果V4.1Flash最终能够做到这一点,影响的就不只是DeepSeek自己的价格表了。
它可能会重新把整个AI Agent市场的Token成本,再往下压一轮。