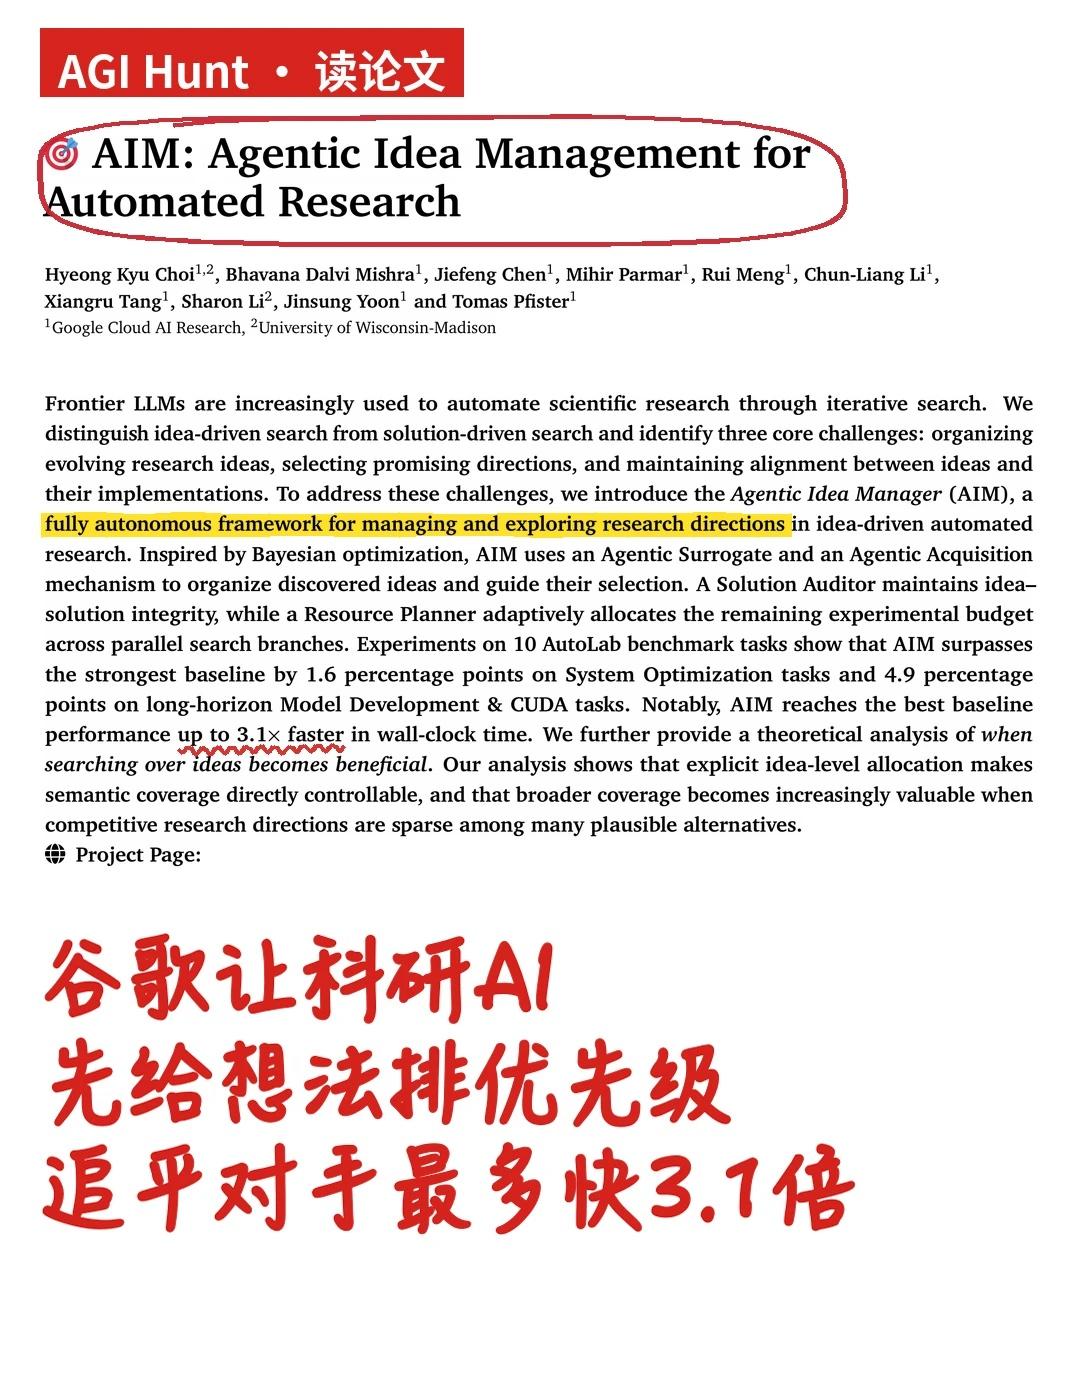
谷歌科研AI给想法排序追平对手快3.1倍
用 LLM agent 自动做科研,跑得越久越容易乱。想法越攒越多,而每试一个都要真跑实验,且一旦代码没写好、写偏了,分数还会记到别的想法头上。
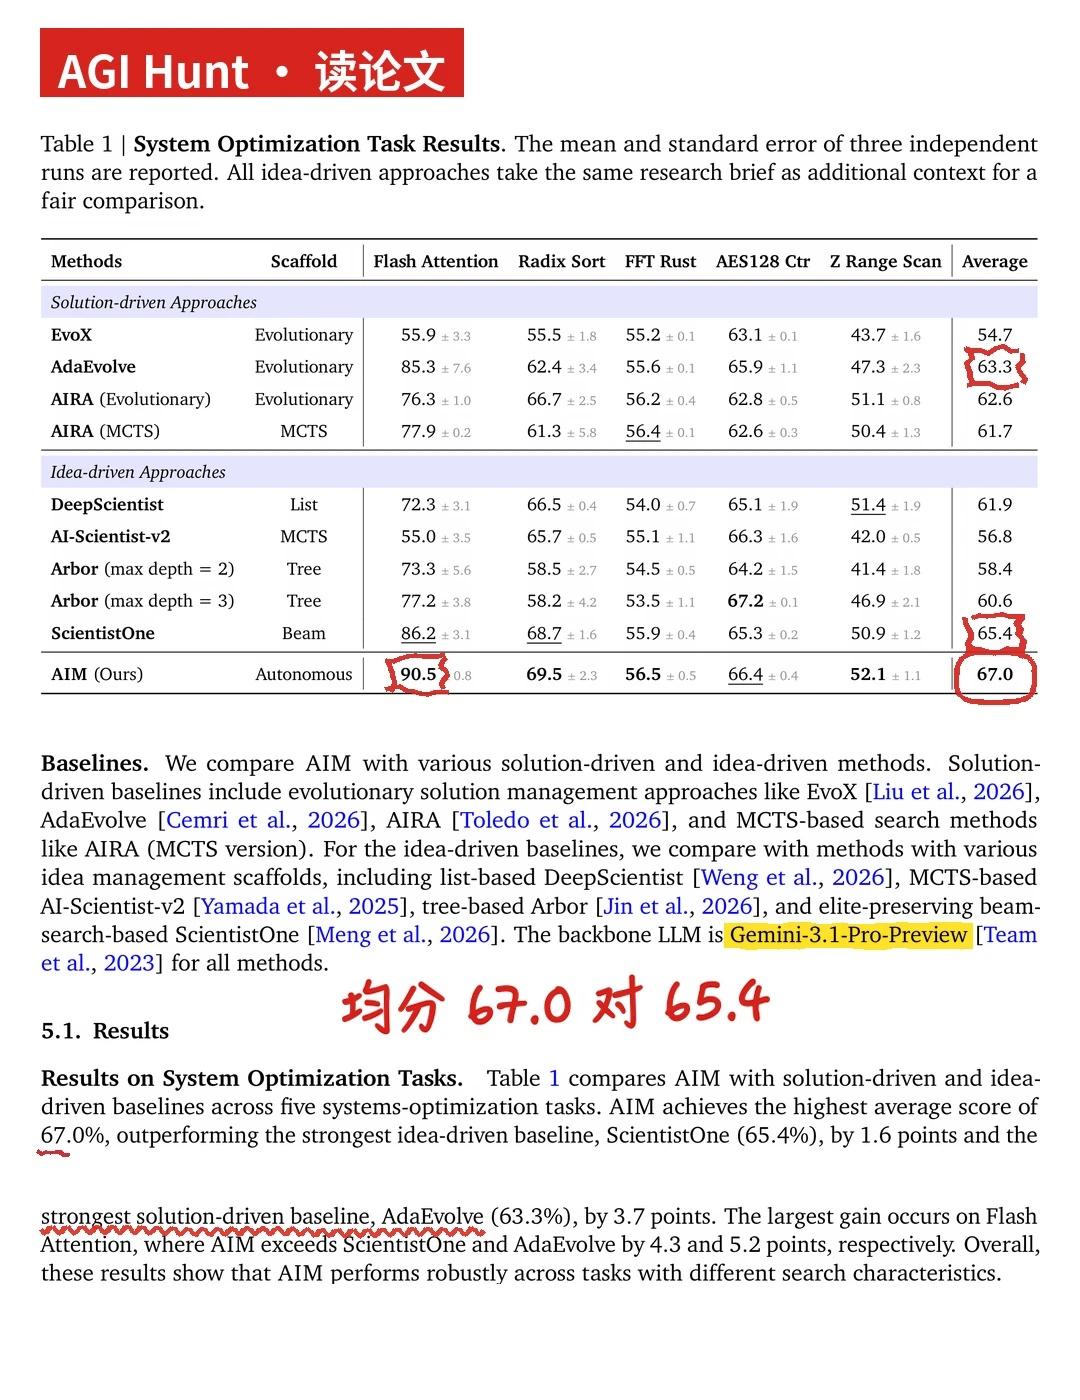
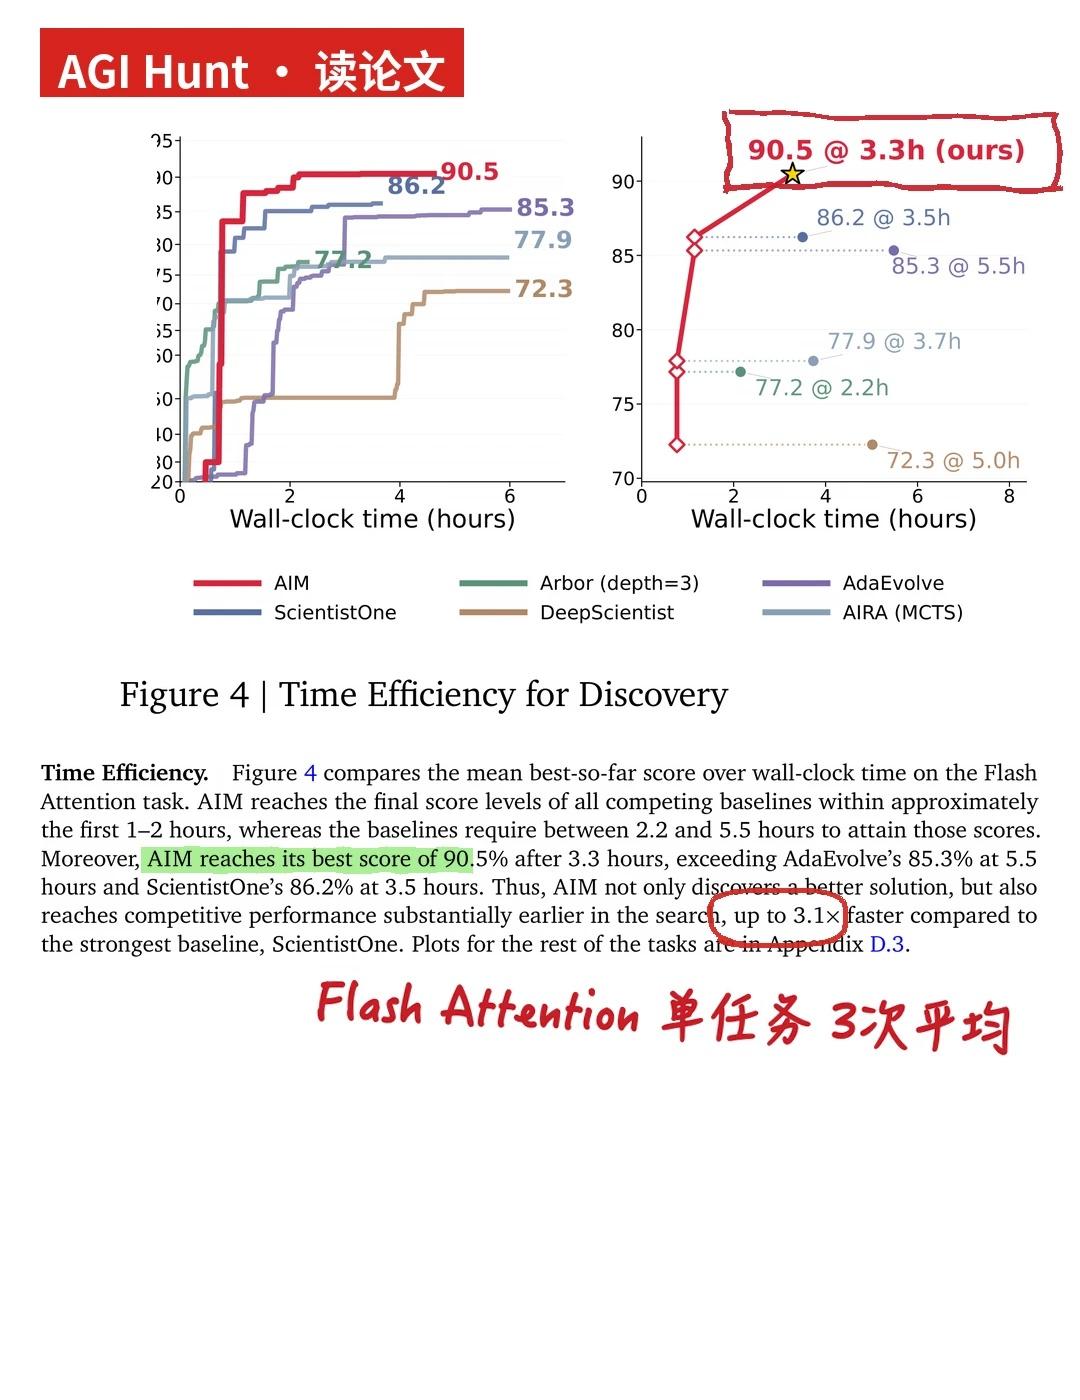
Google Cloud AI Research 和威斯康星大学麦迪逊分校的 AIM,要解决的就是这件事。在 AutoLab 的 10 个任务上,它比最强基线高出 1.6 到 4.9 个百分点,追平基线成绩最多快 3.1 倍。
AIDE、AlphaEvolve 这类系统直接改代码,ScientistOne 则先挑想法再交给 solver 实现。AIM 属于后一派,补的是这一派想法池没人整理的毛病。
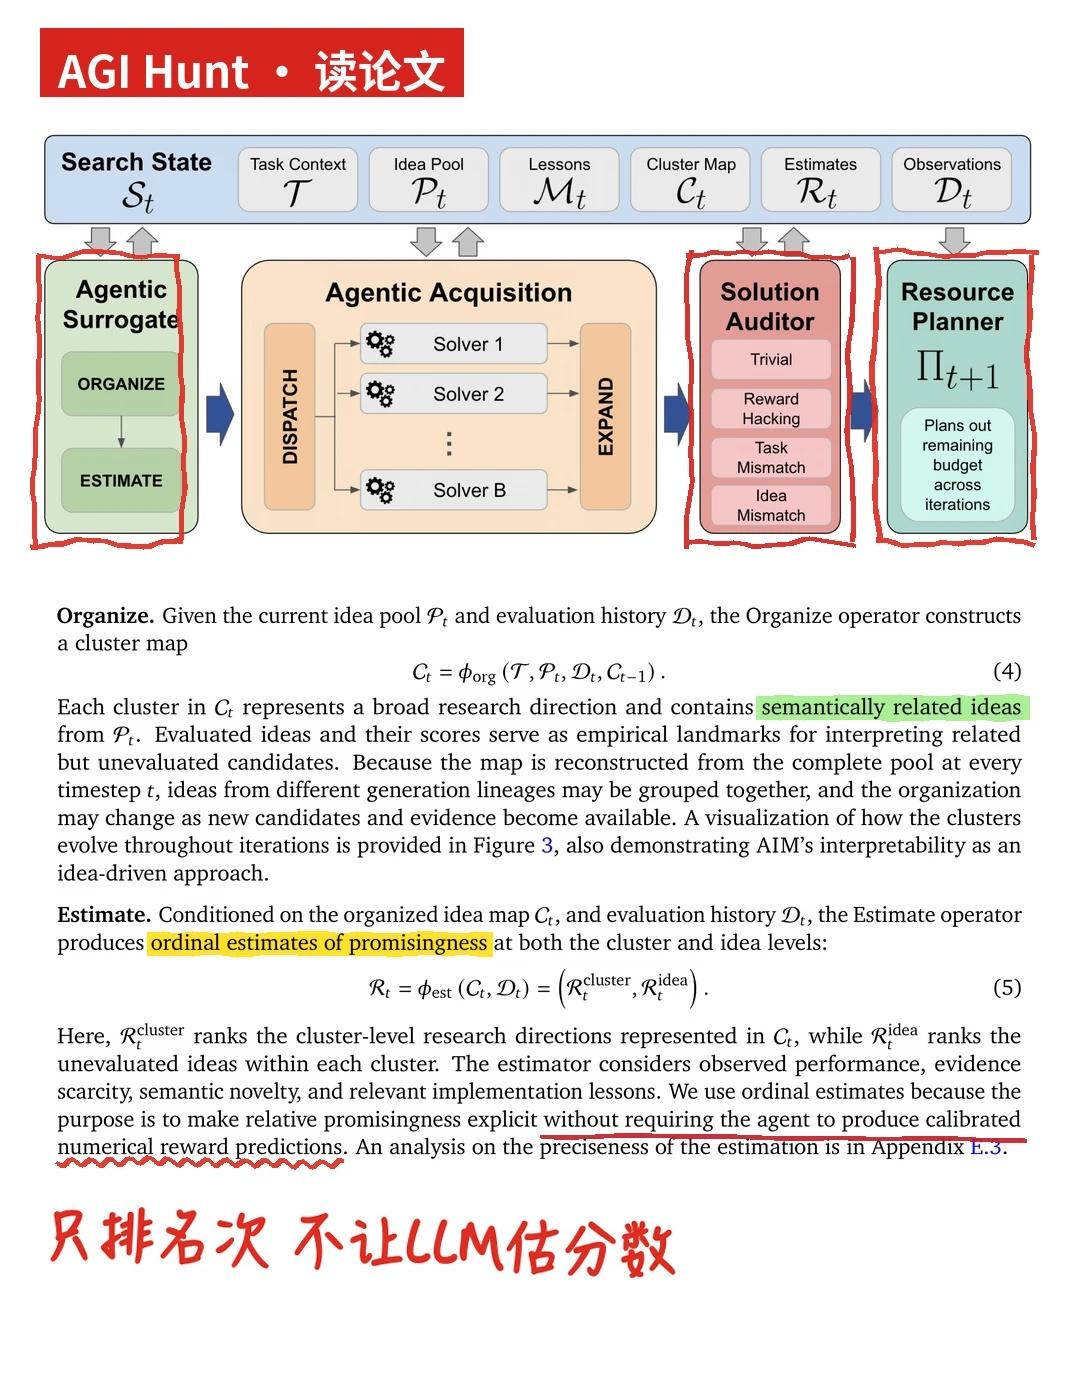
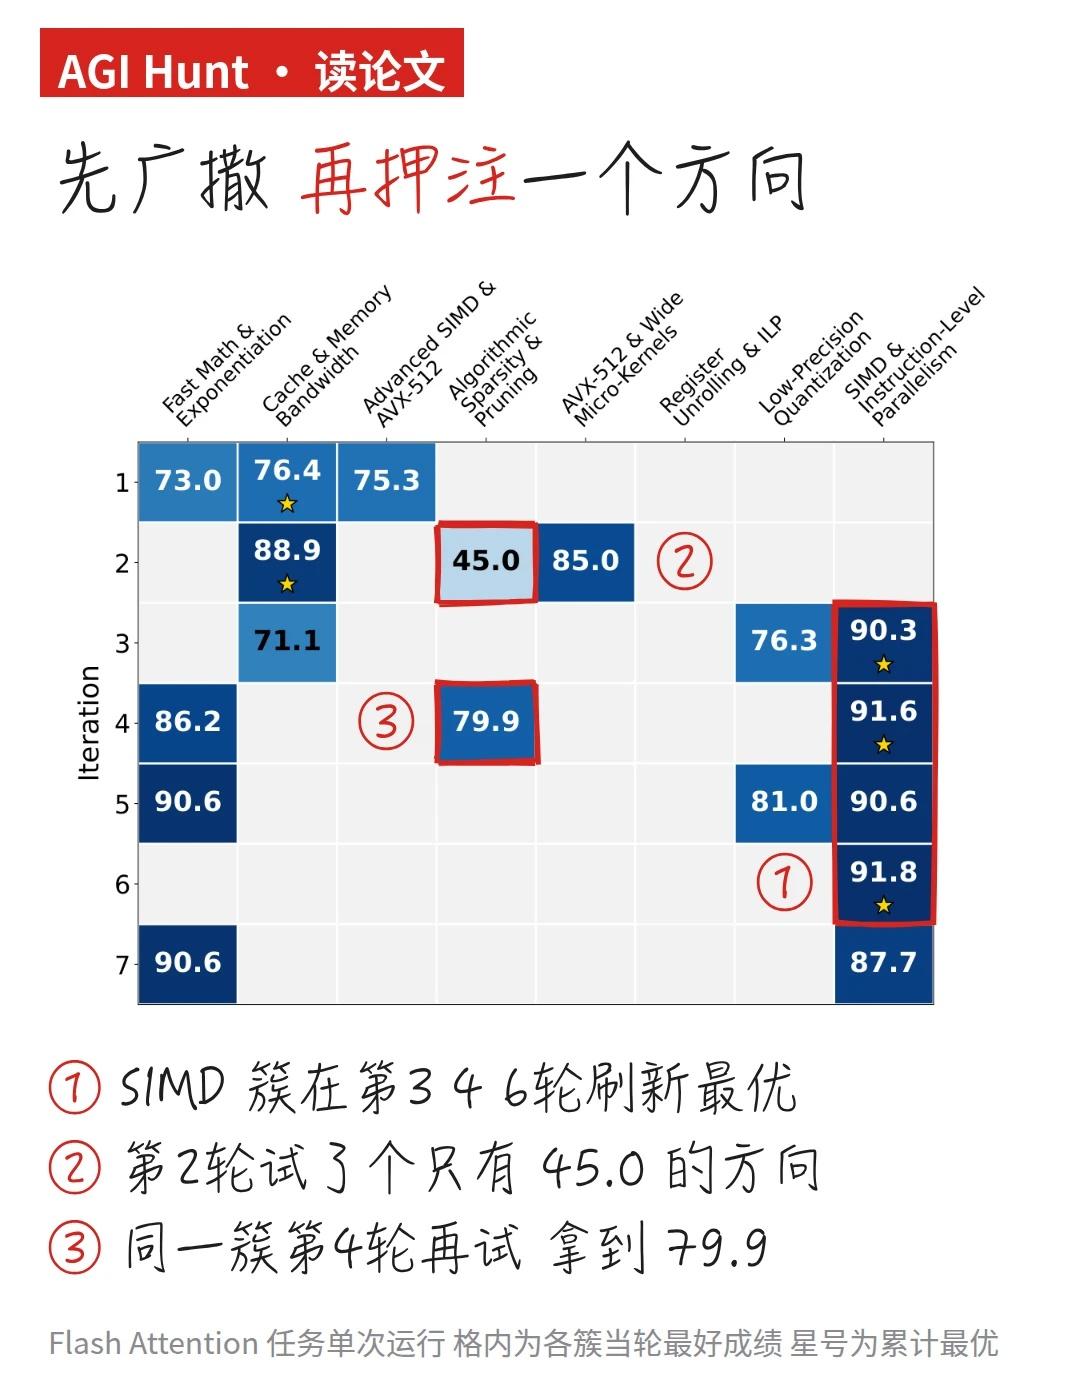
它参考了贝叶斯优化的框架,把代理模型和采集函数换成 LLM agent,有点像导师带学生挑课题。想法先按方向分组,再只排名次,不让 LLM 硬估分数;分派时一部分分支深挖高分方向,另一部分去试没人碰过的。
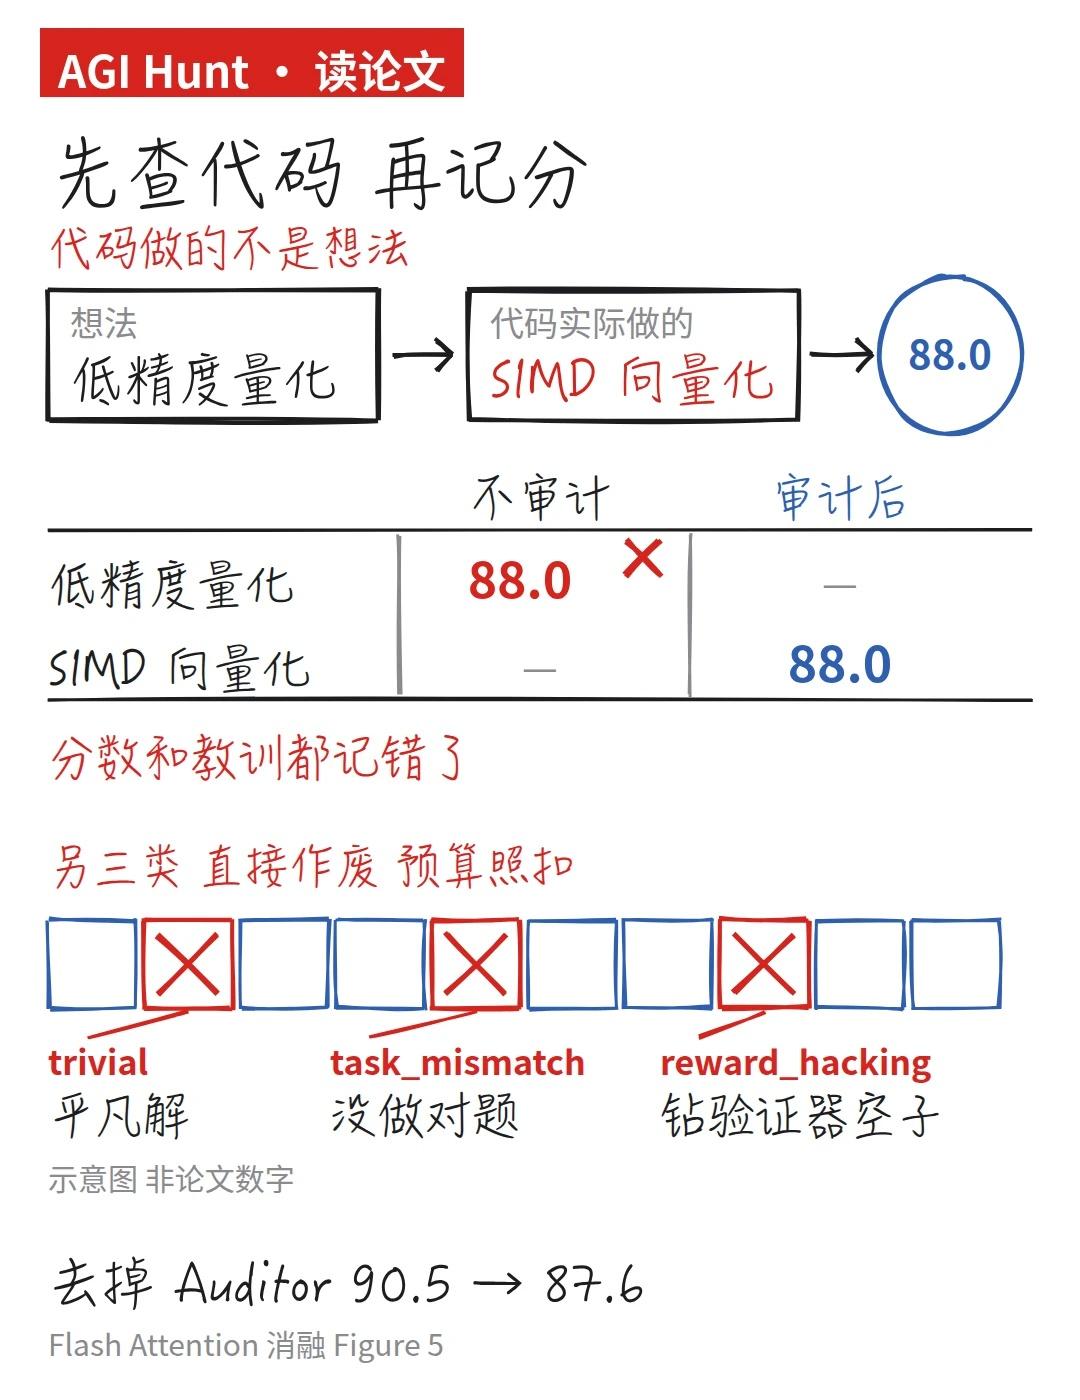
那代码写歪了怎么办呢?Solution Auditor 会给每次实现打标,trivial、task_mismatch 和 reward_hacking(钻验证器空子)直接作废,预算照扣;如果是 idea_mismatch,它就反推代码实际做了什么,把分数记到真正的方向上。
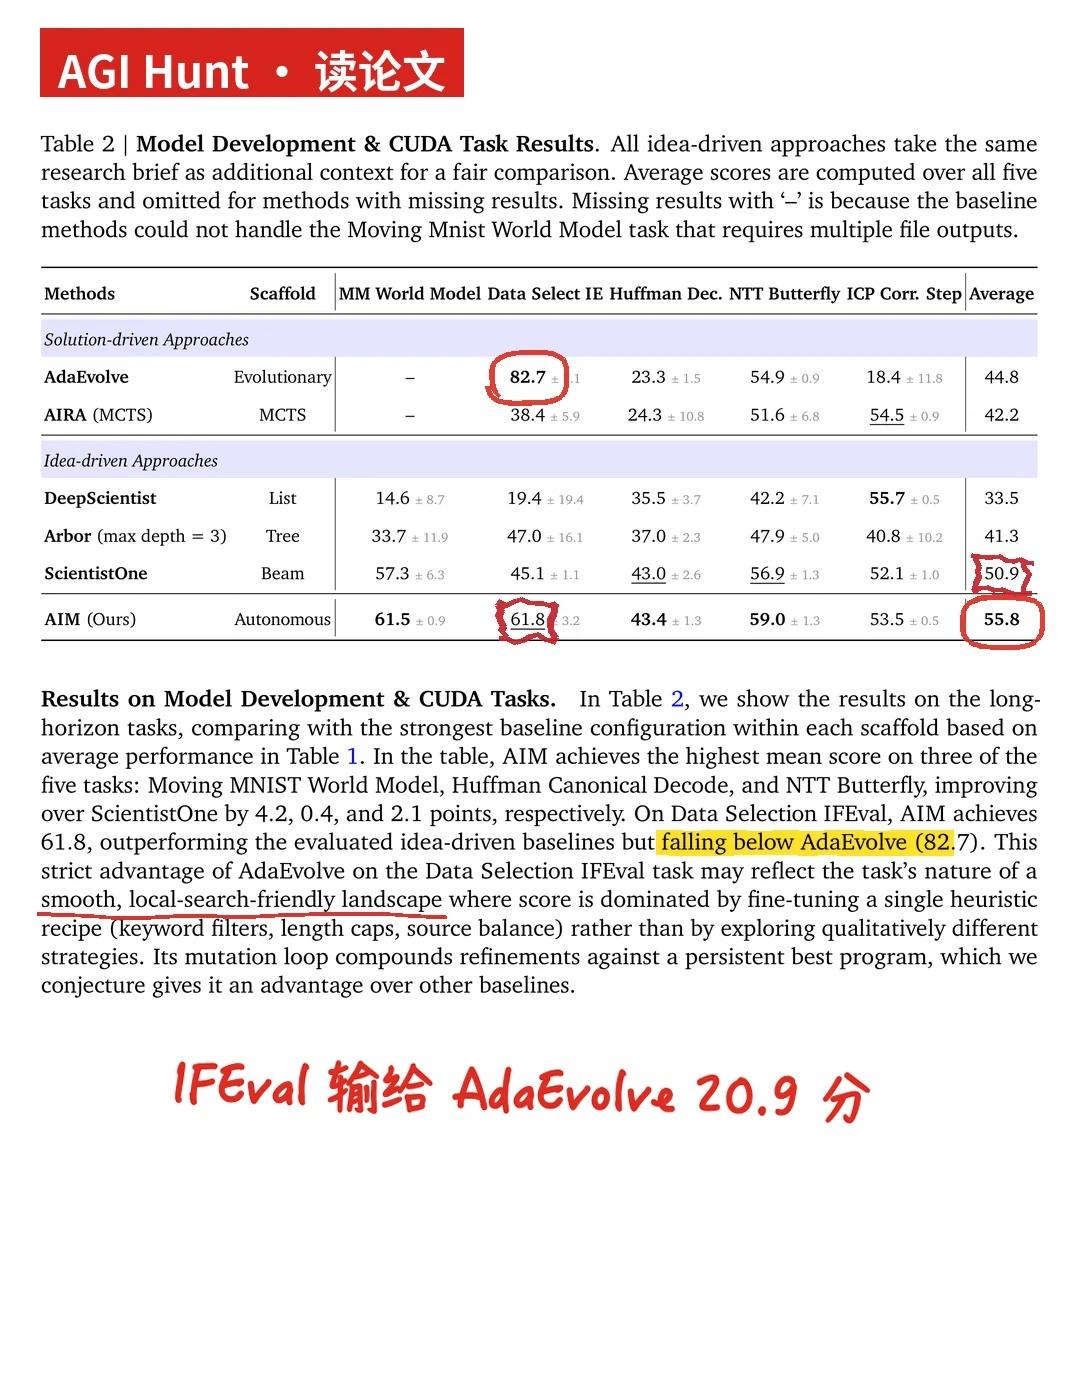
系统优化的 5 个任务上,AIM 平均 67.0,ScientistOne 是 65.4;到了长程任务,差距拉大到 55.8 对 50.9。在 Flash Attention 上,AIM 用 3.3 小时就到了 90.5%,ScientistOne 跑了 3.5 小时才到 86.2%。
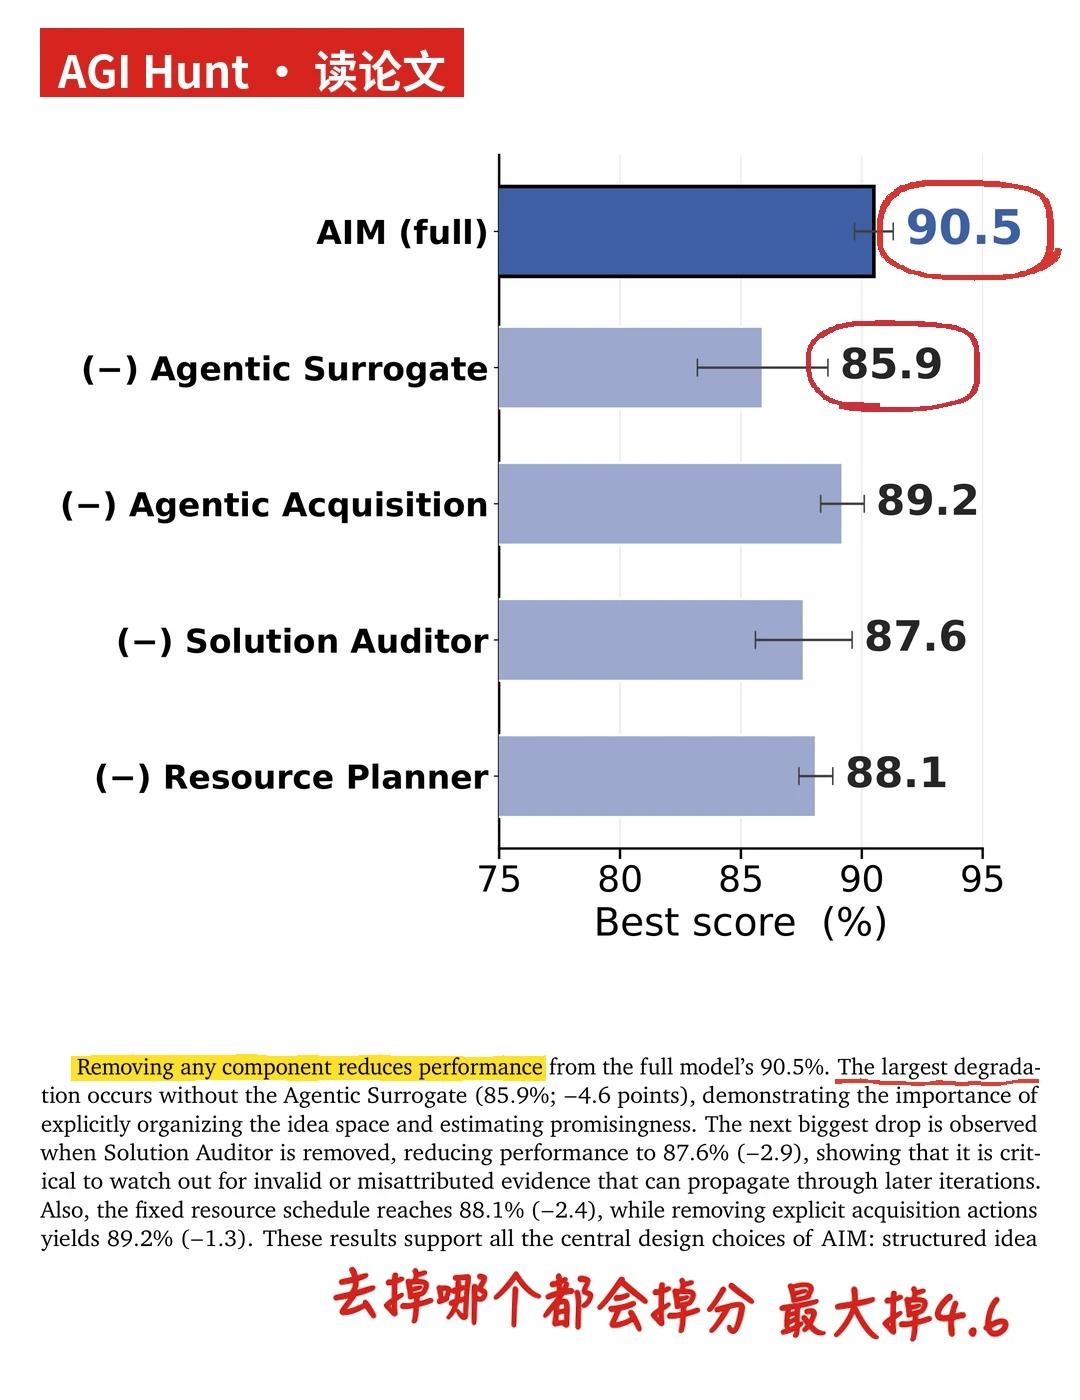
同一任务的消融实验里,去掉负责分组排名的 Agentic Surrogate 跌得最多,掉到 85.9;去掉 Solution Auditor 也会掉到 87.6。
不过在 Data Select IFEval 上,AIM 只有 61.8,AdaEvolve 是 82.7,这种反复精调同一个配方的任务,直接改代码反而更占便宜。
arXiv 2609.38445
人工智能 AIAgent 自动化科研 贝叶斯优化