恺明新作|VISTA:无损视觉记忆驱动交互推理
概况:
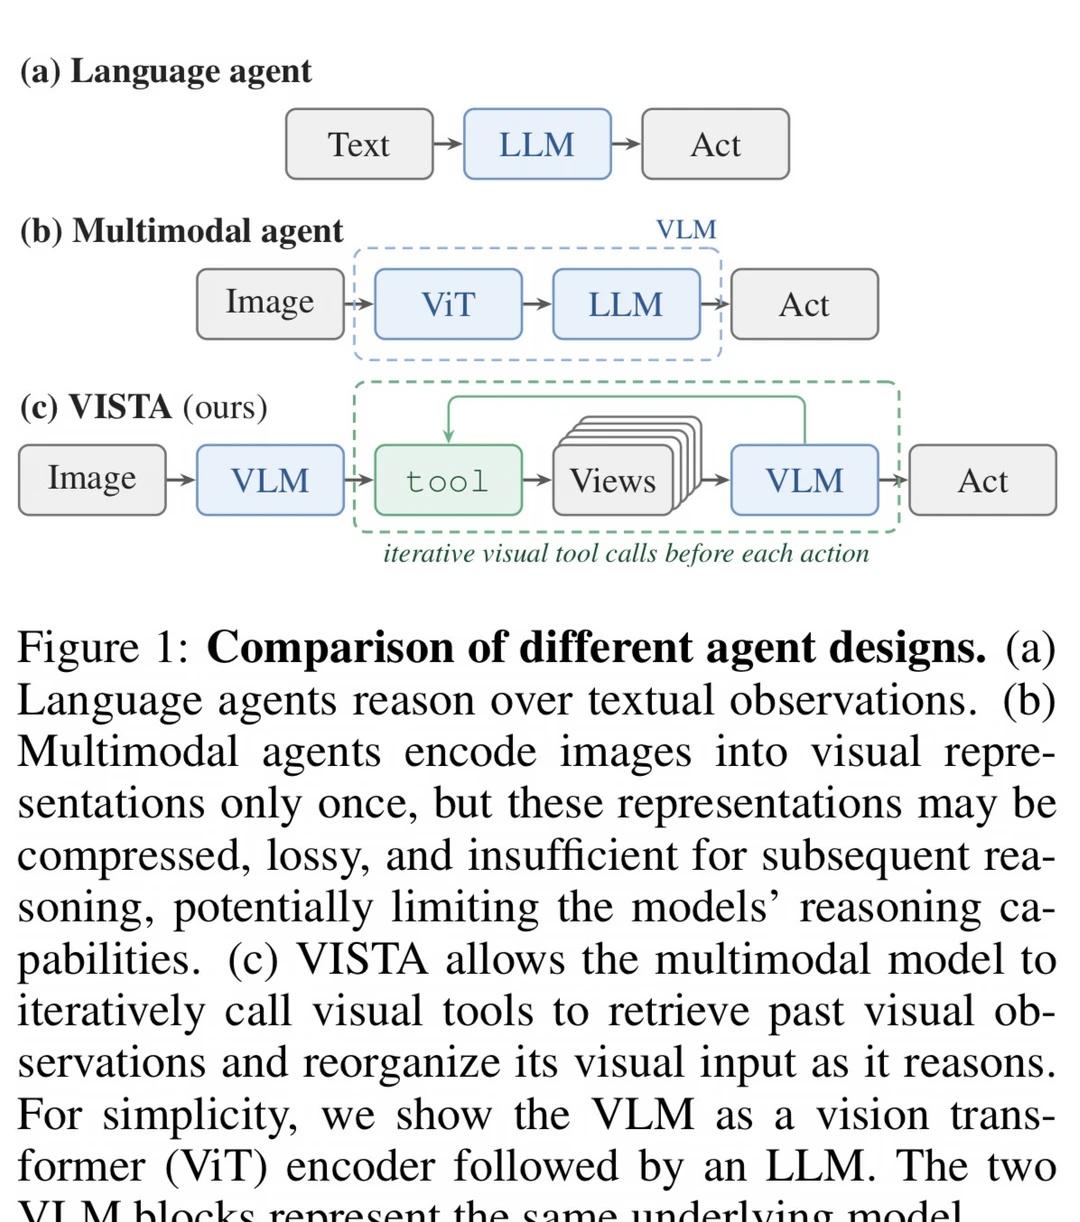
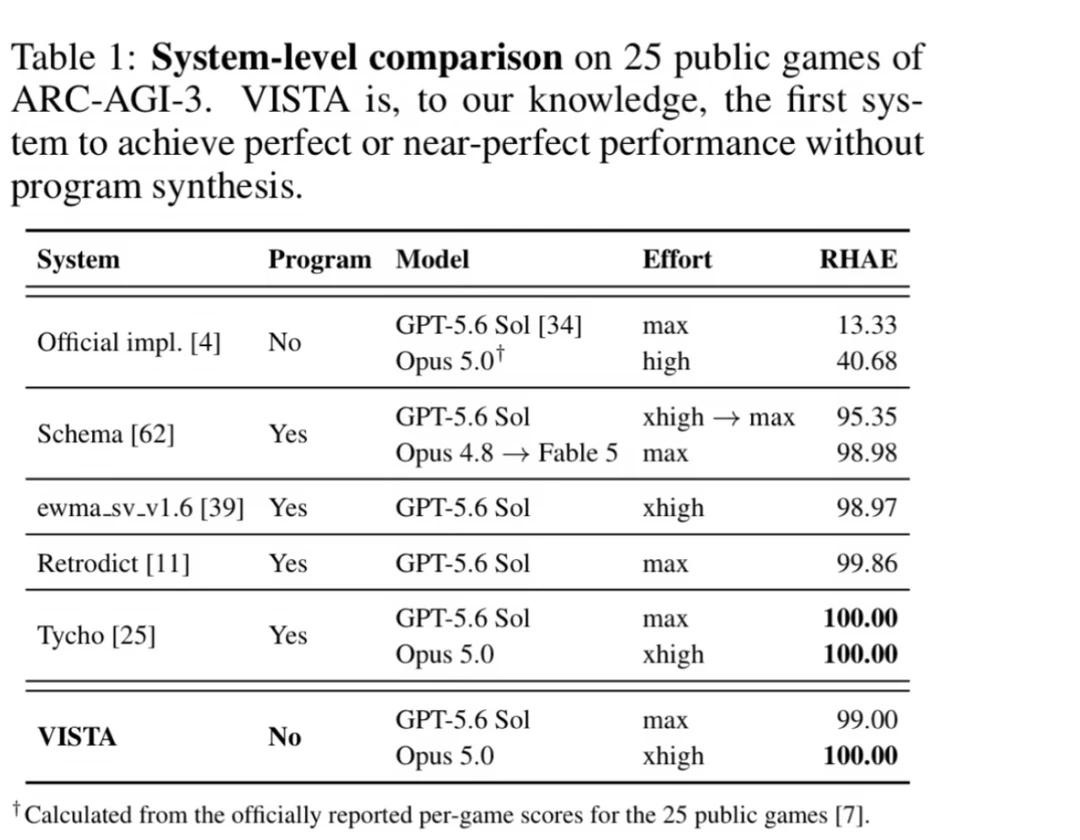
VISTA 不训练新模型,只给多模态大模型加一套“视觉外设”——直接看图 + 无损视觉记忆 + 主动回看,就能把 Claude Opus 5 在 ARC-AGI-3 上从 40.68 分拉到满分 100。
核心问题
现有视觉 Agent 虽然每一步都“看截图”,但实际上:
1 只能看到当前画面,历史细节靠语言记忆或压缩状态,容易丢失;
2 视觉信息常被提前转成文本/embedding,原始细节不可恢复。
关键证据往往藏在那些被丢掉的细节里。
VISTA 的两个关键设计
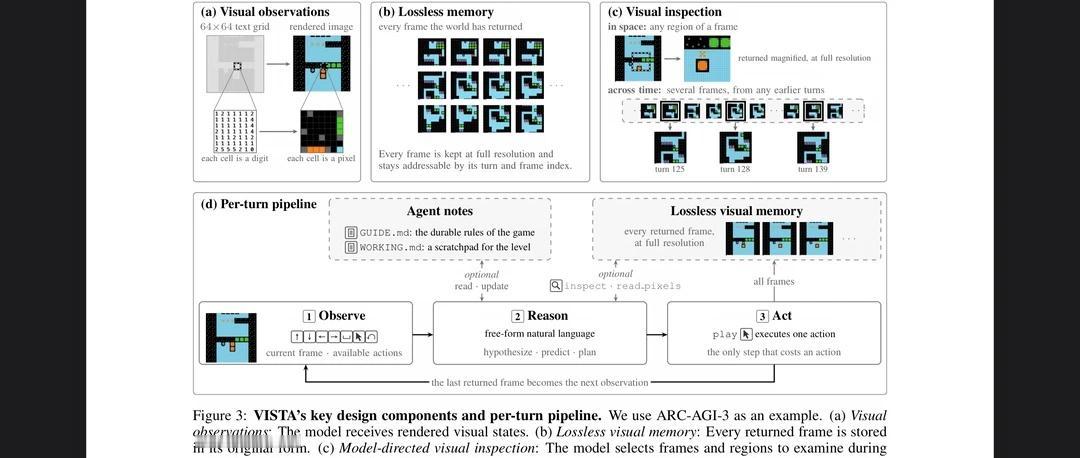
1 直接视觉观察:让模型直接看原始图像,而不是人为总结后的状态,减少信息瓶颈。
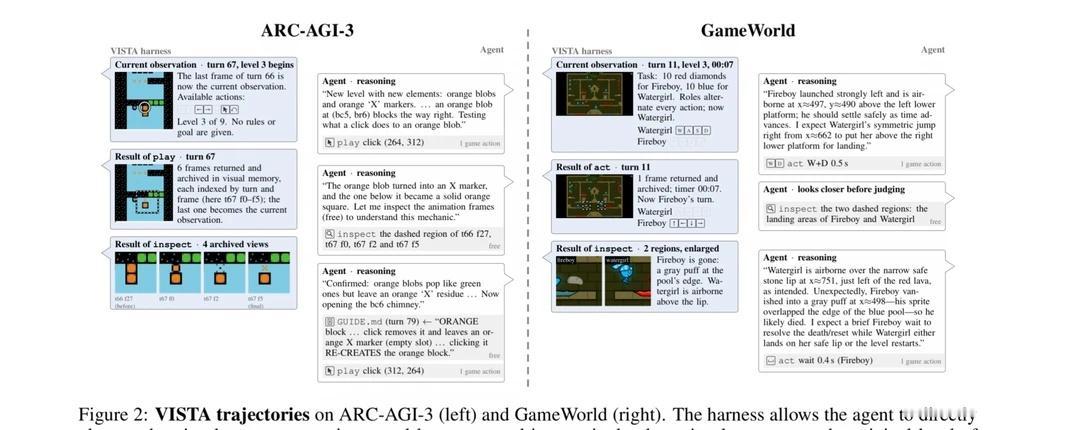
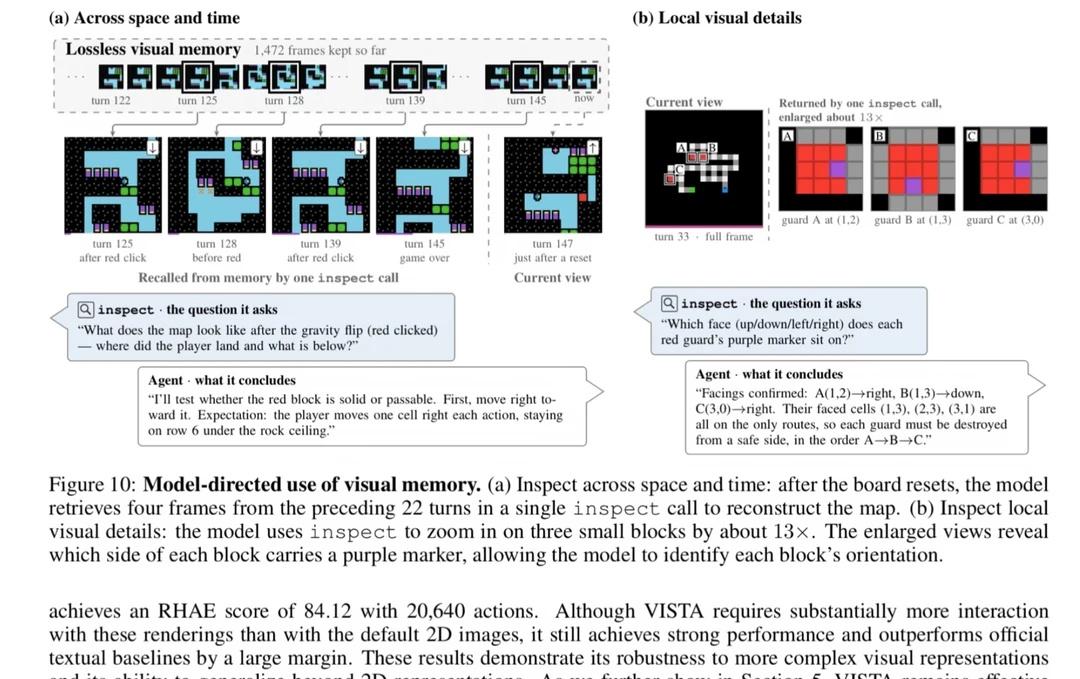
2 无损视觉记忆(Lossless Visual Memory):把过去每一帧完整保存下来(像相册),模型需要时可以主动 inspect 回看、对比、放大,甚至读取精确像素值。回看不消耗行动步数。
整体闭环变成:当前观察 → 发现缺信息 → 主动检索历史画面 → 重新组织证据 → 继续推理 → 行动。
为什么有效
• 信息保真度高,压缩损失小;
• 推理从“我记得”变成“我去查证据”;
• 模型开始主动决定“我现在还需要看什么”,更接近真正的 Agent。
实验亮点
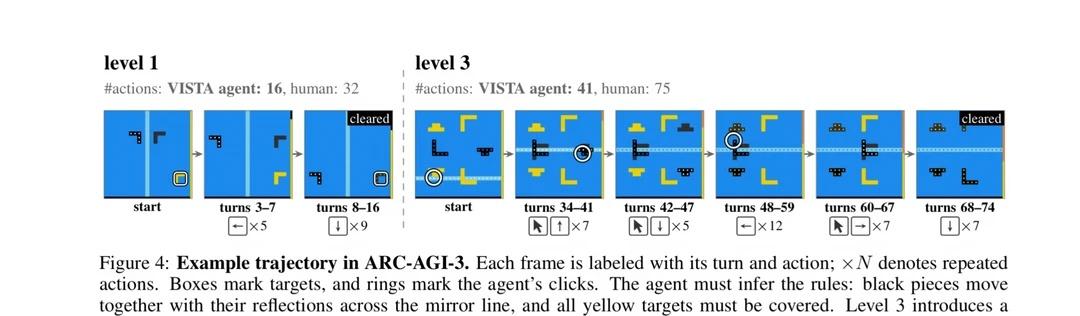
Claude Opus 5 + VISTA 完成全部 25 个公开游戏,满分 100,动作数比人类首次通关少约 57%。说明瓶颈很多时候不是模型智力不够,而是观察与记忆接口不行。
对我最大的启发
真正强的视觉 Agent 不应该只是“看一张图输出答案”,而应具备:
看见 → 保存 → 回看 → 比较 → 主动寻找证据 → 再观察 → 推理 → 行动。
这对游戏 Agent、GUI Agent、机器人、长视频理解、图像取证、遥感分析都有直接参考价值。尤其是取证类任务,可以把原图、局部裁剪、频域图、噪声图、检测器响应等全部存进“取证视觉记忆”,让 Agent 在冲突时主动回看证据,而不是简单投票。
总结:
VISTA 不只是让 AI 看得见,而是让它能记住自己看见过什么,并在需要时主动回去重新看。这可能是视觉 Agent 从“会看图的模型”走向“能在视觉世界中持续推理的 Agent”的关键一步。
howto入门codex AI反常识howto 深度学习 计算机视觉