UCSD:让AI实现游戏自动开发
📖标题:RSIGame: Autonomous Agentic Game Development with Recursive Self-improvement
🌐 2609.39045v1
🛎️文章简介
🔸研究问题:如何让AI在自动生成游戏后,不仅能跑通,还能通过自我迭代修复漏洞、优化体验,避免陷入局部最优或产生新Bug?
🔸主要贡献:论文提出了RSIGAME框架,通过局部探索诊断与全局质量监控相结合的递归自改进机制,并将成功经验内化到模型训练中,显著提升了自动游戏开发的质量与效率。
📝重点思路
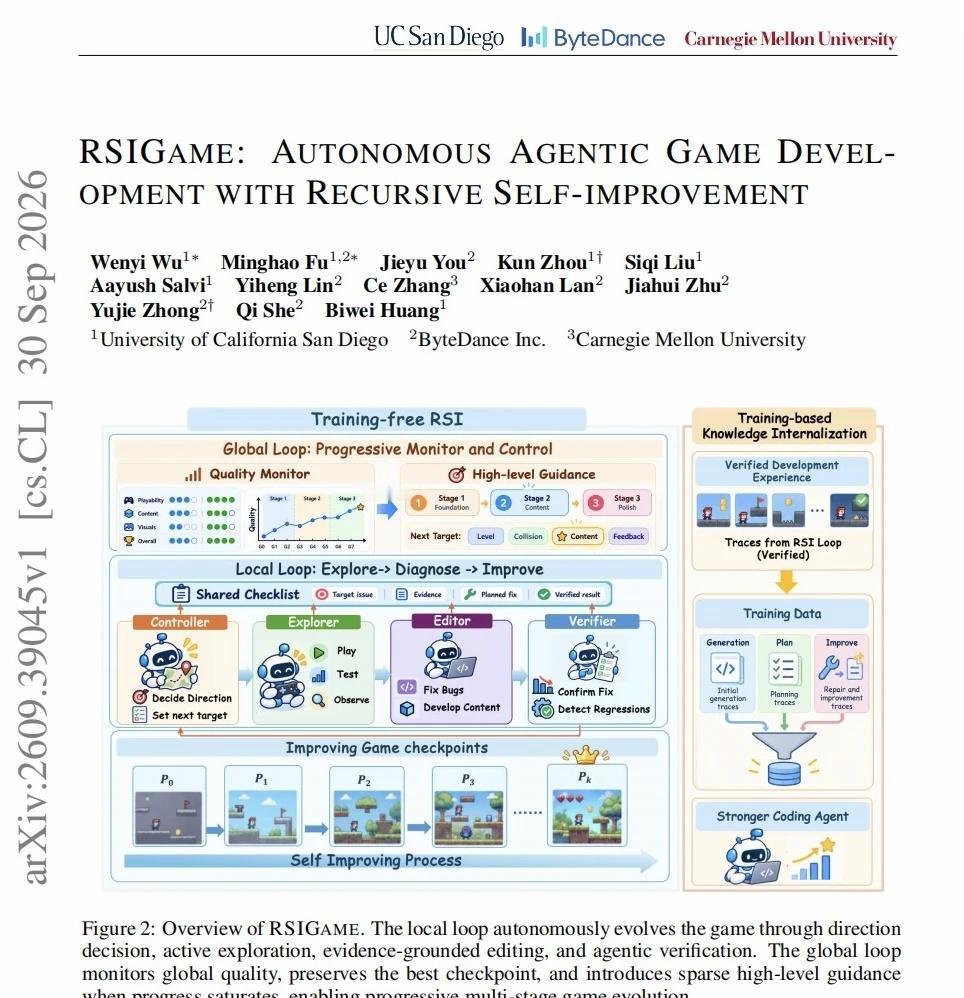
🔸构建局部“探索-诊断-改进”循环:系统包含控制器、探索者、编辑器和验证器四个智能体。控制器决定下一步测试方向,探索者与游戏交互收集证据,编辑器根据证据修改代码,验证器确认修改是否有效且无回归,所有发现存入动态检查清单以指导后续迭代。
🔸引入全局质量监控与控制:全局循环负责跟踪长期开发进度,保存最佳版本快照。当连续多次迭代未产生更优版本时,判定为饱和并停止或引入高层指导,防止盲目修改导致质量倒退。
🔸实施基于训练的经验内化:将成功的开发轨迹(包括规划、生成和经过验证的改进过程)作为监督数据,对基础生成模型进行微调。这使得模型能从参数层面学习开发经验,提升初始生成质量并减少后续迭代所需的计算资源。
🔎分析总结
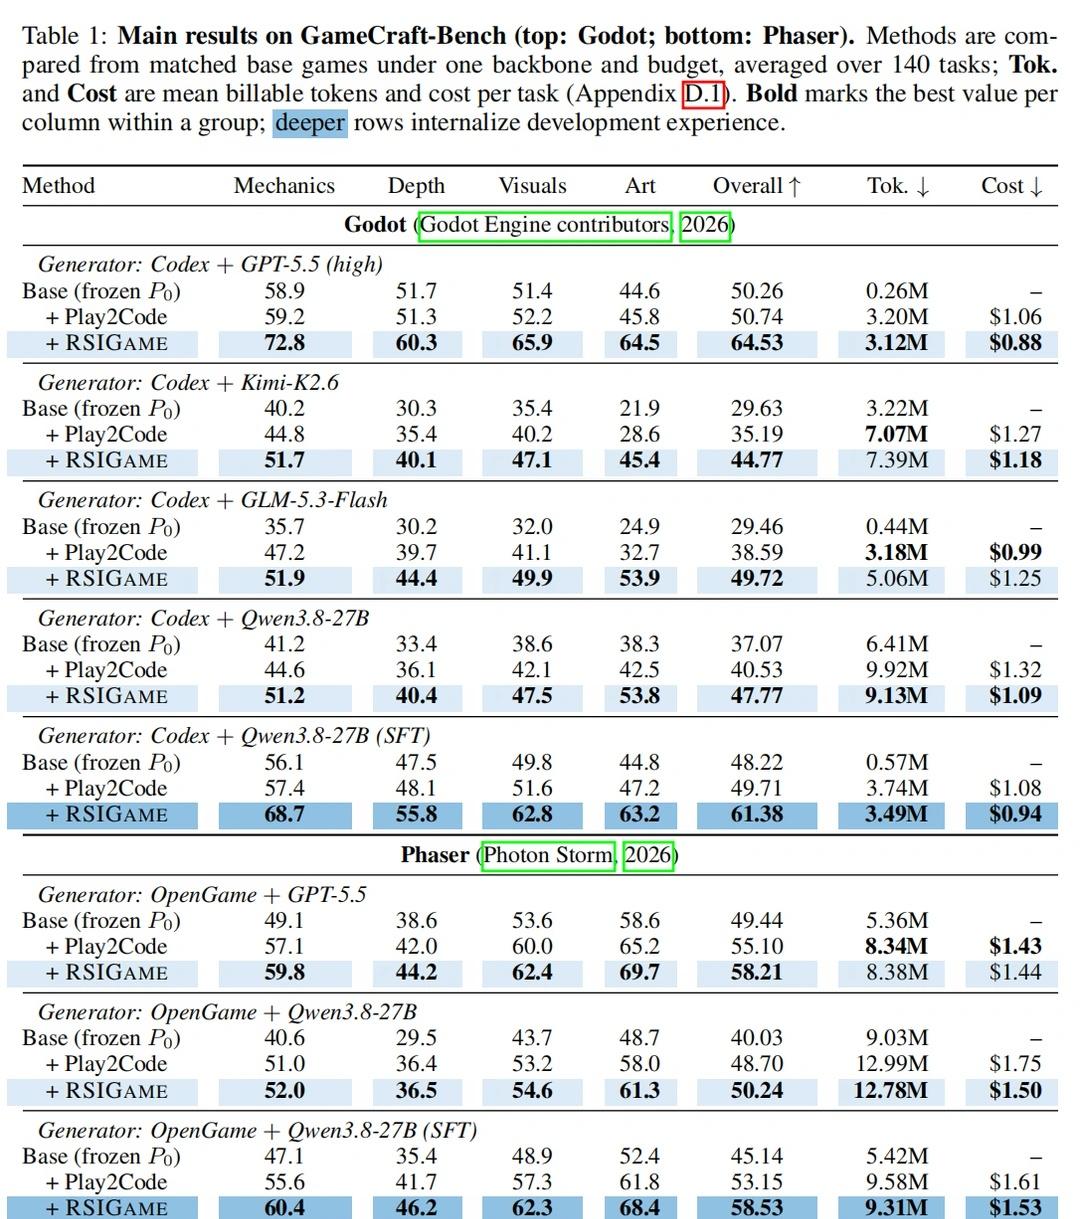
🔸RSIGAME在Godot和Phaser两个引擎、140个任务及多种生成器上均表现出一致且显著的质量提升,优于现有的Play2Code等迭代方法。
🔸全局质量监控有效解决了迭代过程中的波动问题,通过保留最佳快照,确保了随着开发轮次增加,游戏质量能持续稳定上升而非震荡或退化。
🔸经验内化效果惊人,经过微调的Qwen3.8-27B模型在单次生成得分上超越了更强的GPT-5.5,同时生成本令牌数量减少了11倍,证明了将调试经验转化为模型能力的有效性。
🔸自适应开发策略优于固定流程,系统能根据当前游戏状态(如构建失败或美术短板)动态调整资源分配,从而获得更好的最终结果。
💡个人观点
论文模拟了人类软件工程中“测试-反馈-修复”的闭环,将“试错经验”不仅用于当下的修正,还通过微调反哺给模型本身。
LLM 大模型 agent 论文分享