华为昇腾份额超50%,英伟达为何四年跌破8%
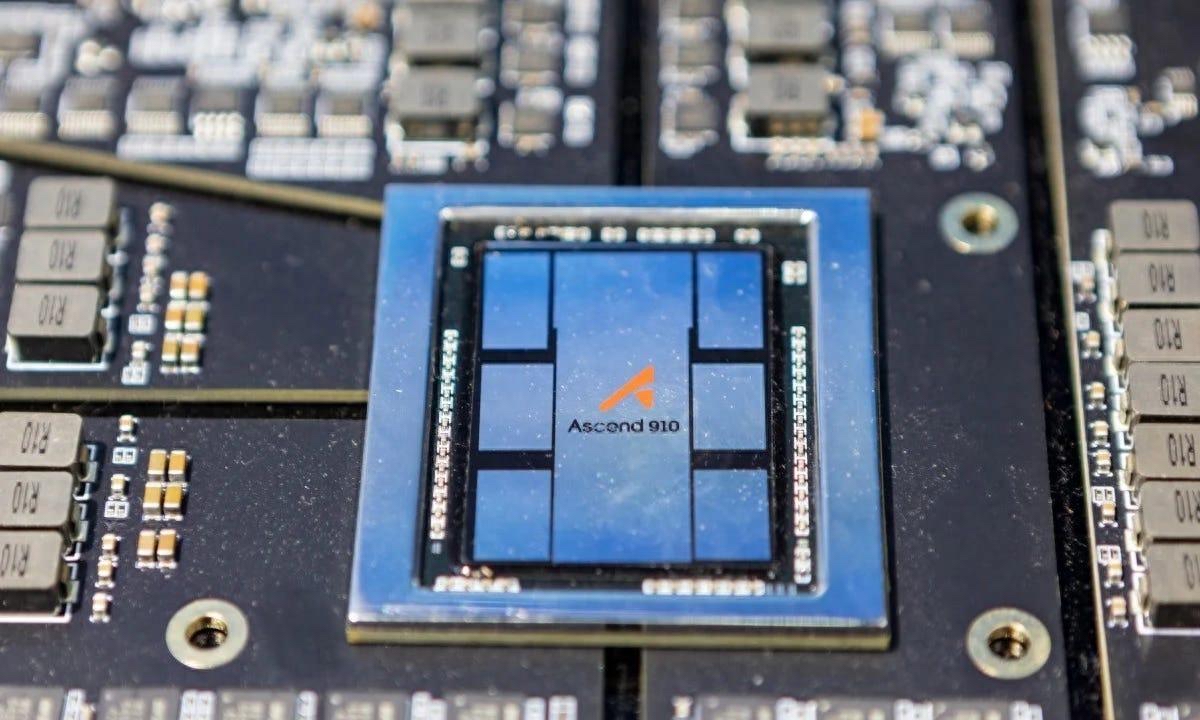
2026年10月初,一组中国AI芯片市场数据引发关注。华为昇腾份额已经超过50%,英伟达则从2022年的95%左右,跌到8%以下。四年时间,市场位置几乎来了个大转弯,这到底是芯片性能突然反超,还是一场供应链和软件生态的重新洗牌?
答案没那么简单。
2022年,美国连续收紧高算力芯片出口限制,A100、H100等产品无法正常供应中国市场。当时不少人判断,中国大模型训练会因为缺少先进芯片而放慢,英伟达也一度占据中国AI芯片市场约95%的份额,华为昇腾只有3%左右。
结果呢,禁令没有让中国市场停止发展,反而把原本流向英伟达的采购预算,快速推向了国产芯片企业。
英伟达当然不想轻易放弃中国市场,于是推出了符合限制要求的H20。它保留了较大的显存和带宽,却明显压低了核心算力,整体性能和H100存在明显差距,售价据称达到1.5万美元左右。
这张卡为什么让客户犹豫?
拿它训练大模型,单卡算力不够,训练周期会被拉长,电力、机房和运维成本跟着上升。拿它做推理,虽然显存够用,但价格又不算便宜。对云厂商来说,真正要算的不是一张卡能不能买,而是每投入一块钱,能跑出多少有效算力。
早期,一些互联网公司确实采购过H20,毕竟大模型业务不能停,手里有卡总比没卡强。可当企业把账算细后,问题就暴露出来了。特供芯片既没有顶级产品的性能,又没有国产方案的供应确定性和本地适配优势,继续大规模采购的理由越来越少。
说白了,客户买的不是芯片包装,而是整套算力服务。价格高、性能弱、后续供应还存在不确定性,谁愿意长期押注?
真正改变市场的,也不是某一颗昇腾芯片突然在所有指标上超过了英伟达,而是华为开始把芯片、服务器、网络、软件工具和集群管理放到一起解决。
单卡性能仍然重要吗?当然重要。但训练千亿甚至万亿参数模型时,企业面对的是几千张、几万张,甚至十几万张卡同时工作。只要通信堵塞、温度异常、设备掉线,整个训练任务就可能受到影响。
这时候,芯片峰值算力只是其中一项,卡与卡之间能不能快速传数据,软件能不能调度好,出现故障后能不能及时恢复,同样决定了最终效率。
华为2018年推出达芬奇架构,已经开始围绕标量、向量和矩阵计算搭建AI处理能力。后来,HCCL集合通信库和灵衢总线协议继续补上集群互联短板,重点解决大规模设备之间的数据传输和协同问题。
这个思路可以简单理解为,单个运动员未必在每一项都拿第一,但如果一支队伍配合顺畅,整体比赛结果就可能完全不同。
DeepSeek在内蒙古等数据中心部署超过16万张华为昇腾加速卡,就是一个有代表性的应用样本。大规模集群能否连续运行,看的不只是某张卡的最高速度,还要看整体稳定性和任务效率。相关运行表现显示,稳定率和线性效率达到99%以上,这说明国产方案已经开始从单卡竞争转向系统竞争。
当然,集群数量大并不自动等于技术领先。设备规模越大,网络设计、散热、电力供应和软件调度越复杂,任何一环出现问题,都可能把优势抵消掉。华为能否持续把大规模集群的成本控制住,仍要看后续产品迭代和商业化表现。
但市场已经发生变化,客户的评价标准也变了。
过去,很多开发者认为离开英伟达几乎不可能,原因不只是CUDA硬件加速,而是全球大量AI代码都围绕CUDA写成。企业如果换平台,就可能面对框架适配、底层代码重写、模型重新调优等一连串麻烦。
华为没有要求开发者从头学习一套完全陌生的语言,而是通过CANN和Torch-NPU,尽量降低迁移门槛。很多PyTorch项目只需要把运行设备从cuda改成npu,主要的模型逻辑不必全部推倒重来。
这一步看起来只是改几个设备标识,实际意义却不小。企业最怕的不是买不到卡,而是换了卡之后,过去几年积累的代码、模型和工程经验全部失效。只要迁移成本降下来,国产芯片就有机会进入更多真实业务,而不只是停留在测试和展示阶段。
2025年8月,CANN底层全面开源,开源社区中非华为开发者数量已经超过华为自有工程师。这个变化说明,芯片生态不再只是厂商自己的事情,越来越多开发者开始参与工具链适配和性能优化。
四年前,华为在中国AI芯片市场只有约3%,英伟达接近95%。如今,昇腾超过50%,英伟达跌破8%。这场变化的核心,不只是某个品牌多卖了多少芯片,而是一个市场从单一依赖走向了系统替代。
接下来真正值得观察的,是国产算力能否从满足国内需求,走到更大范围的商业输出。英伟达又能否重新拿出让客户愿意买单的产品和生态?答案,可能不在发布会,而在下一轮大模型训练的成本、速度和稳定性里。