之前我让 ChatGPT 和 Jev 下国际象棋,21 回合就把 Jev KO 了。可 Jev 打游戏的爆款一个比一个猛,我原来以为,这些项目会像使用大模型带上前面的历史那样,把玩过的经历也喂给 Jev,让它边玩边学,「越玩越强」。
于是我和我的 agent 把最火的 Minecraft 屠龙从源码到作者说明拆了一遍。
我们的结论是:这个项目没让 Jev 自己从玩过的经历里学;屠龙变快,是作者一版版修改的整套系统在变强,不是 Jev 自己「越玩越强」。
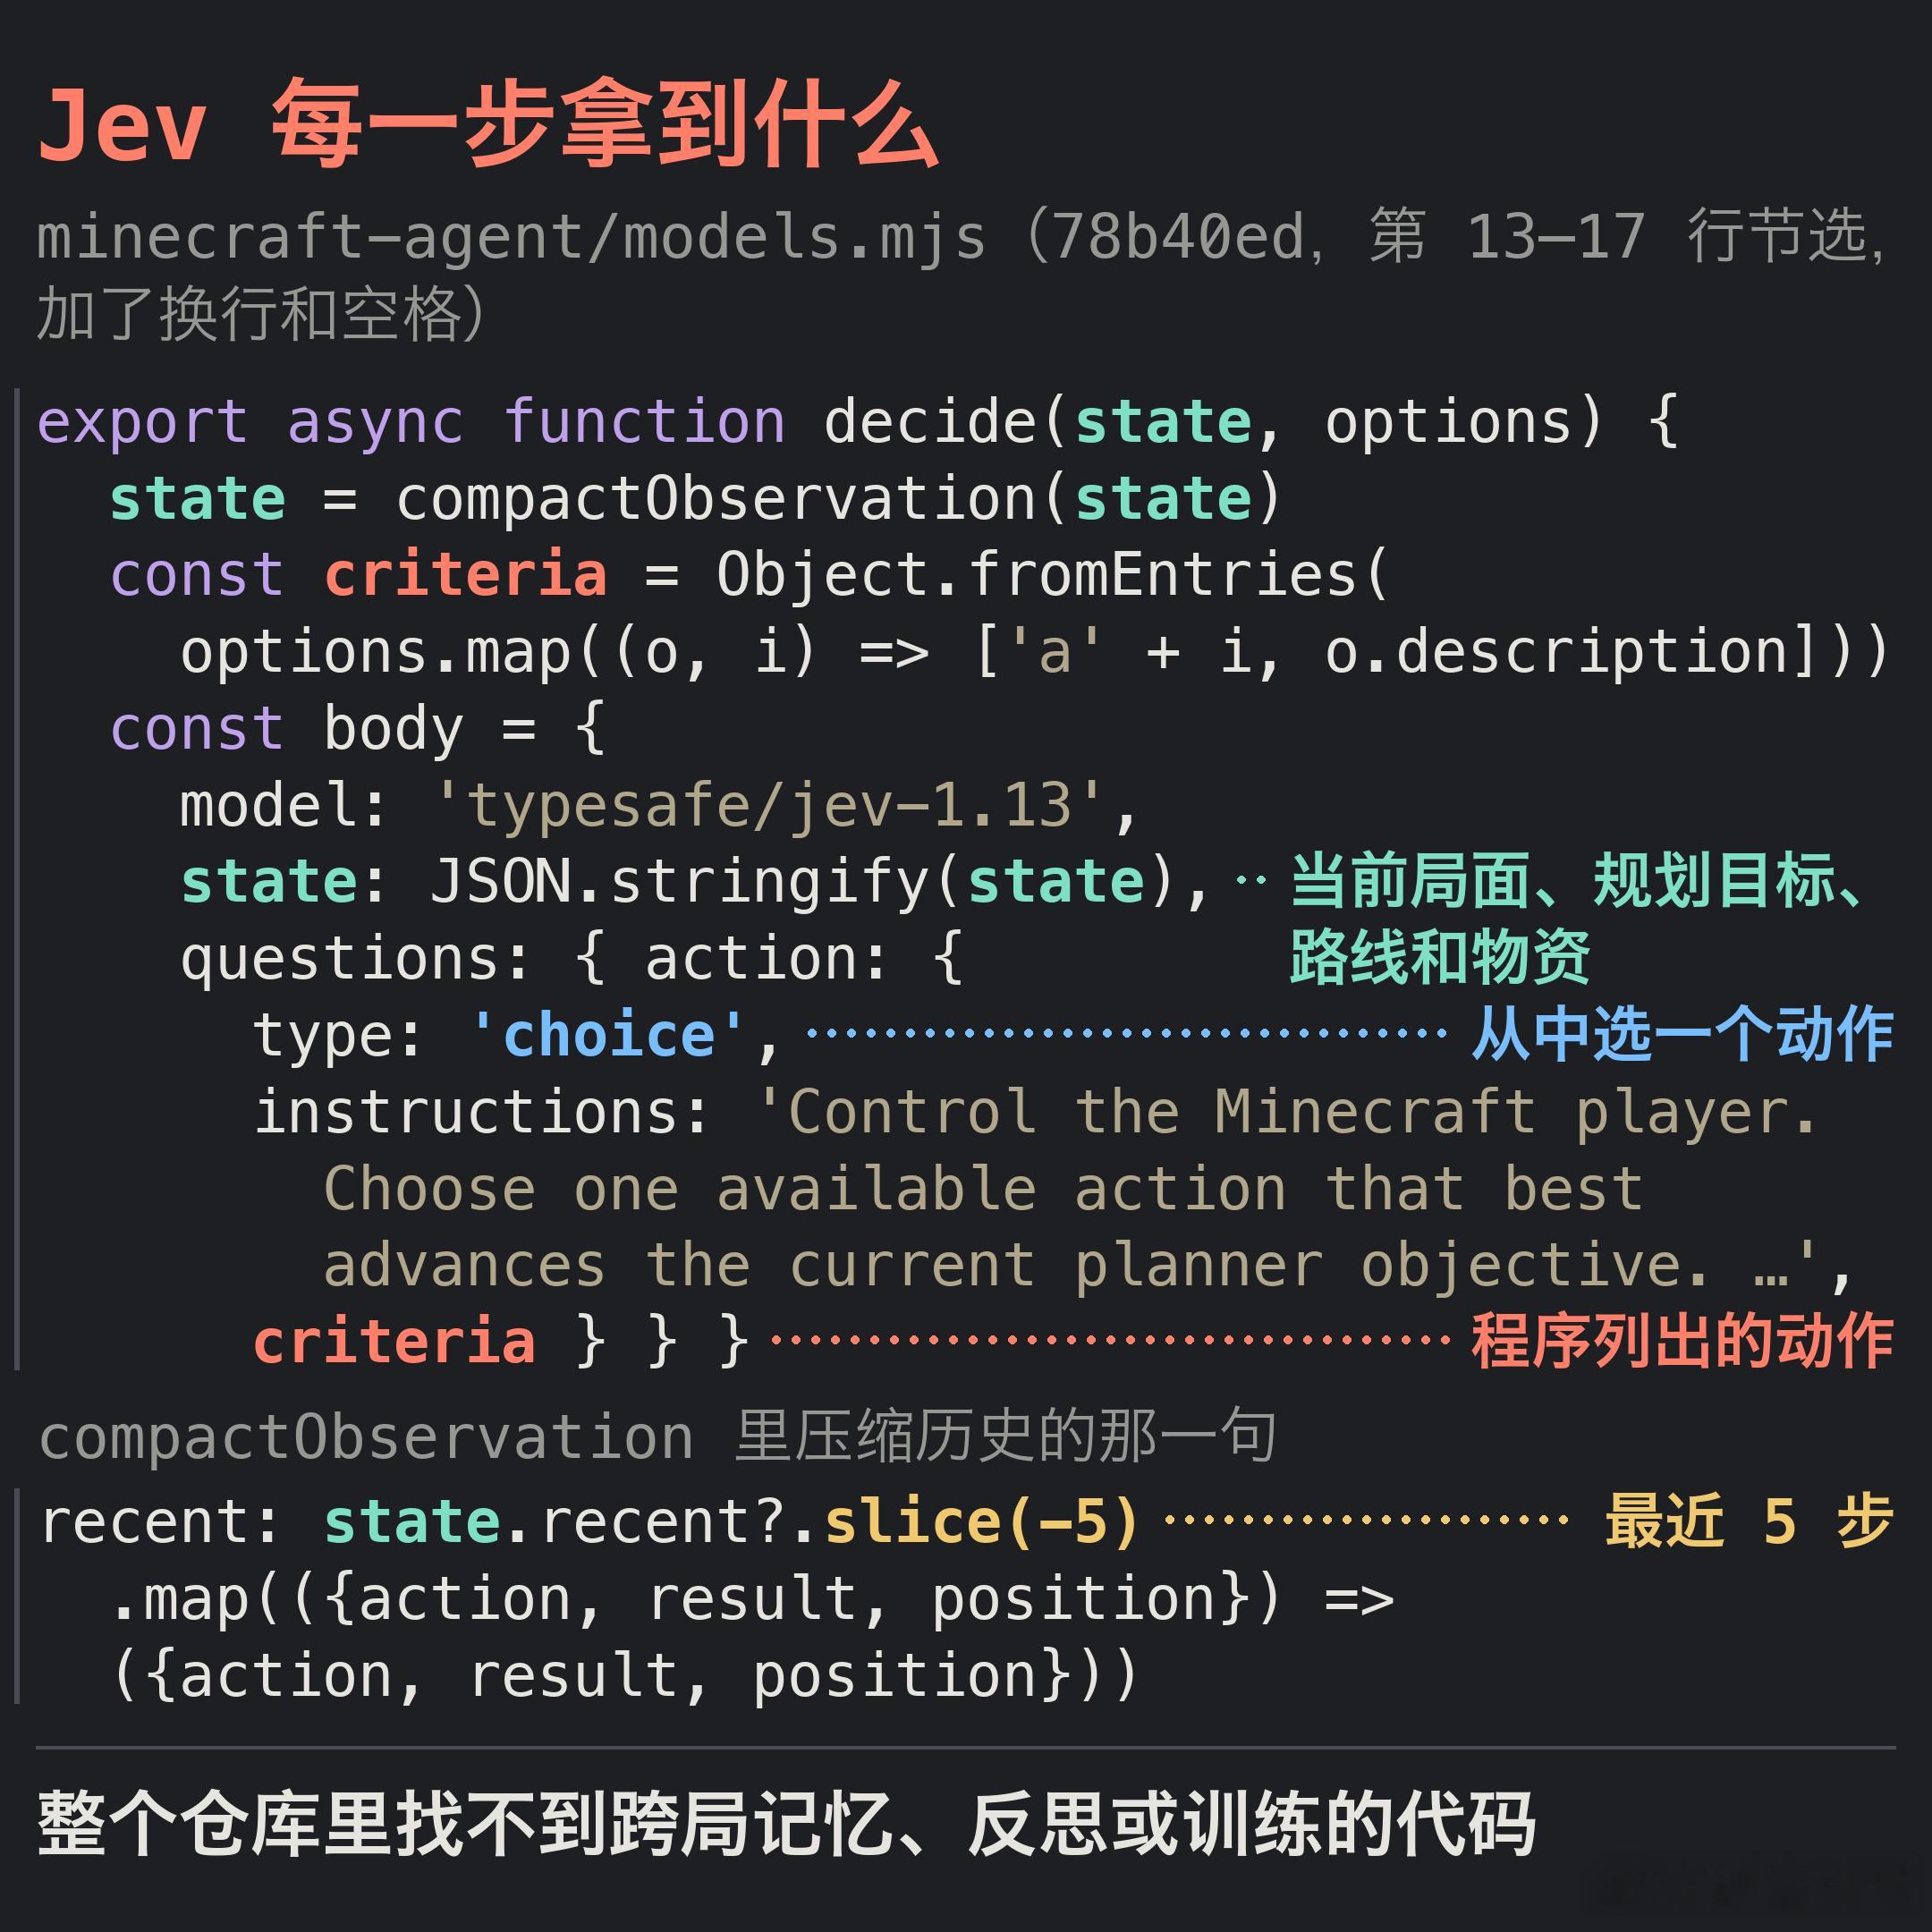
1️⃣ Jev 没有跨局记忆,也没有反思或训练;前几局的教训,是作者总结成文字、写进给它的指示里的。这个项目是两个模型分工:大模型(推文里用的是 Astra)负责规划,定下当前目标;Jev 负责每一步做什么。程序每步交给 Jev 的,主要是当前局面、规划定下的目标、最近 5 步做了什么和结果,以及预先给好的路线坐标和要准备的物资。Jev 从列出的动作里选一个。
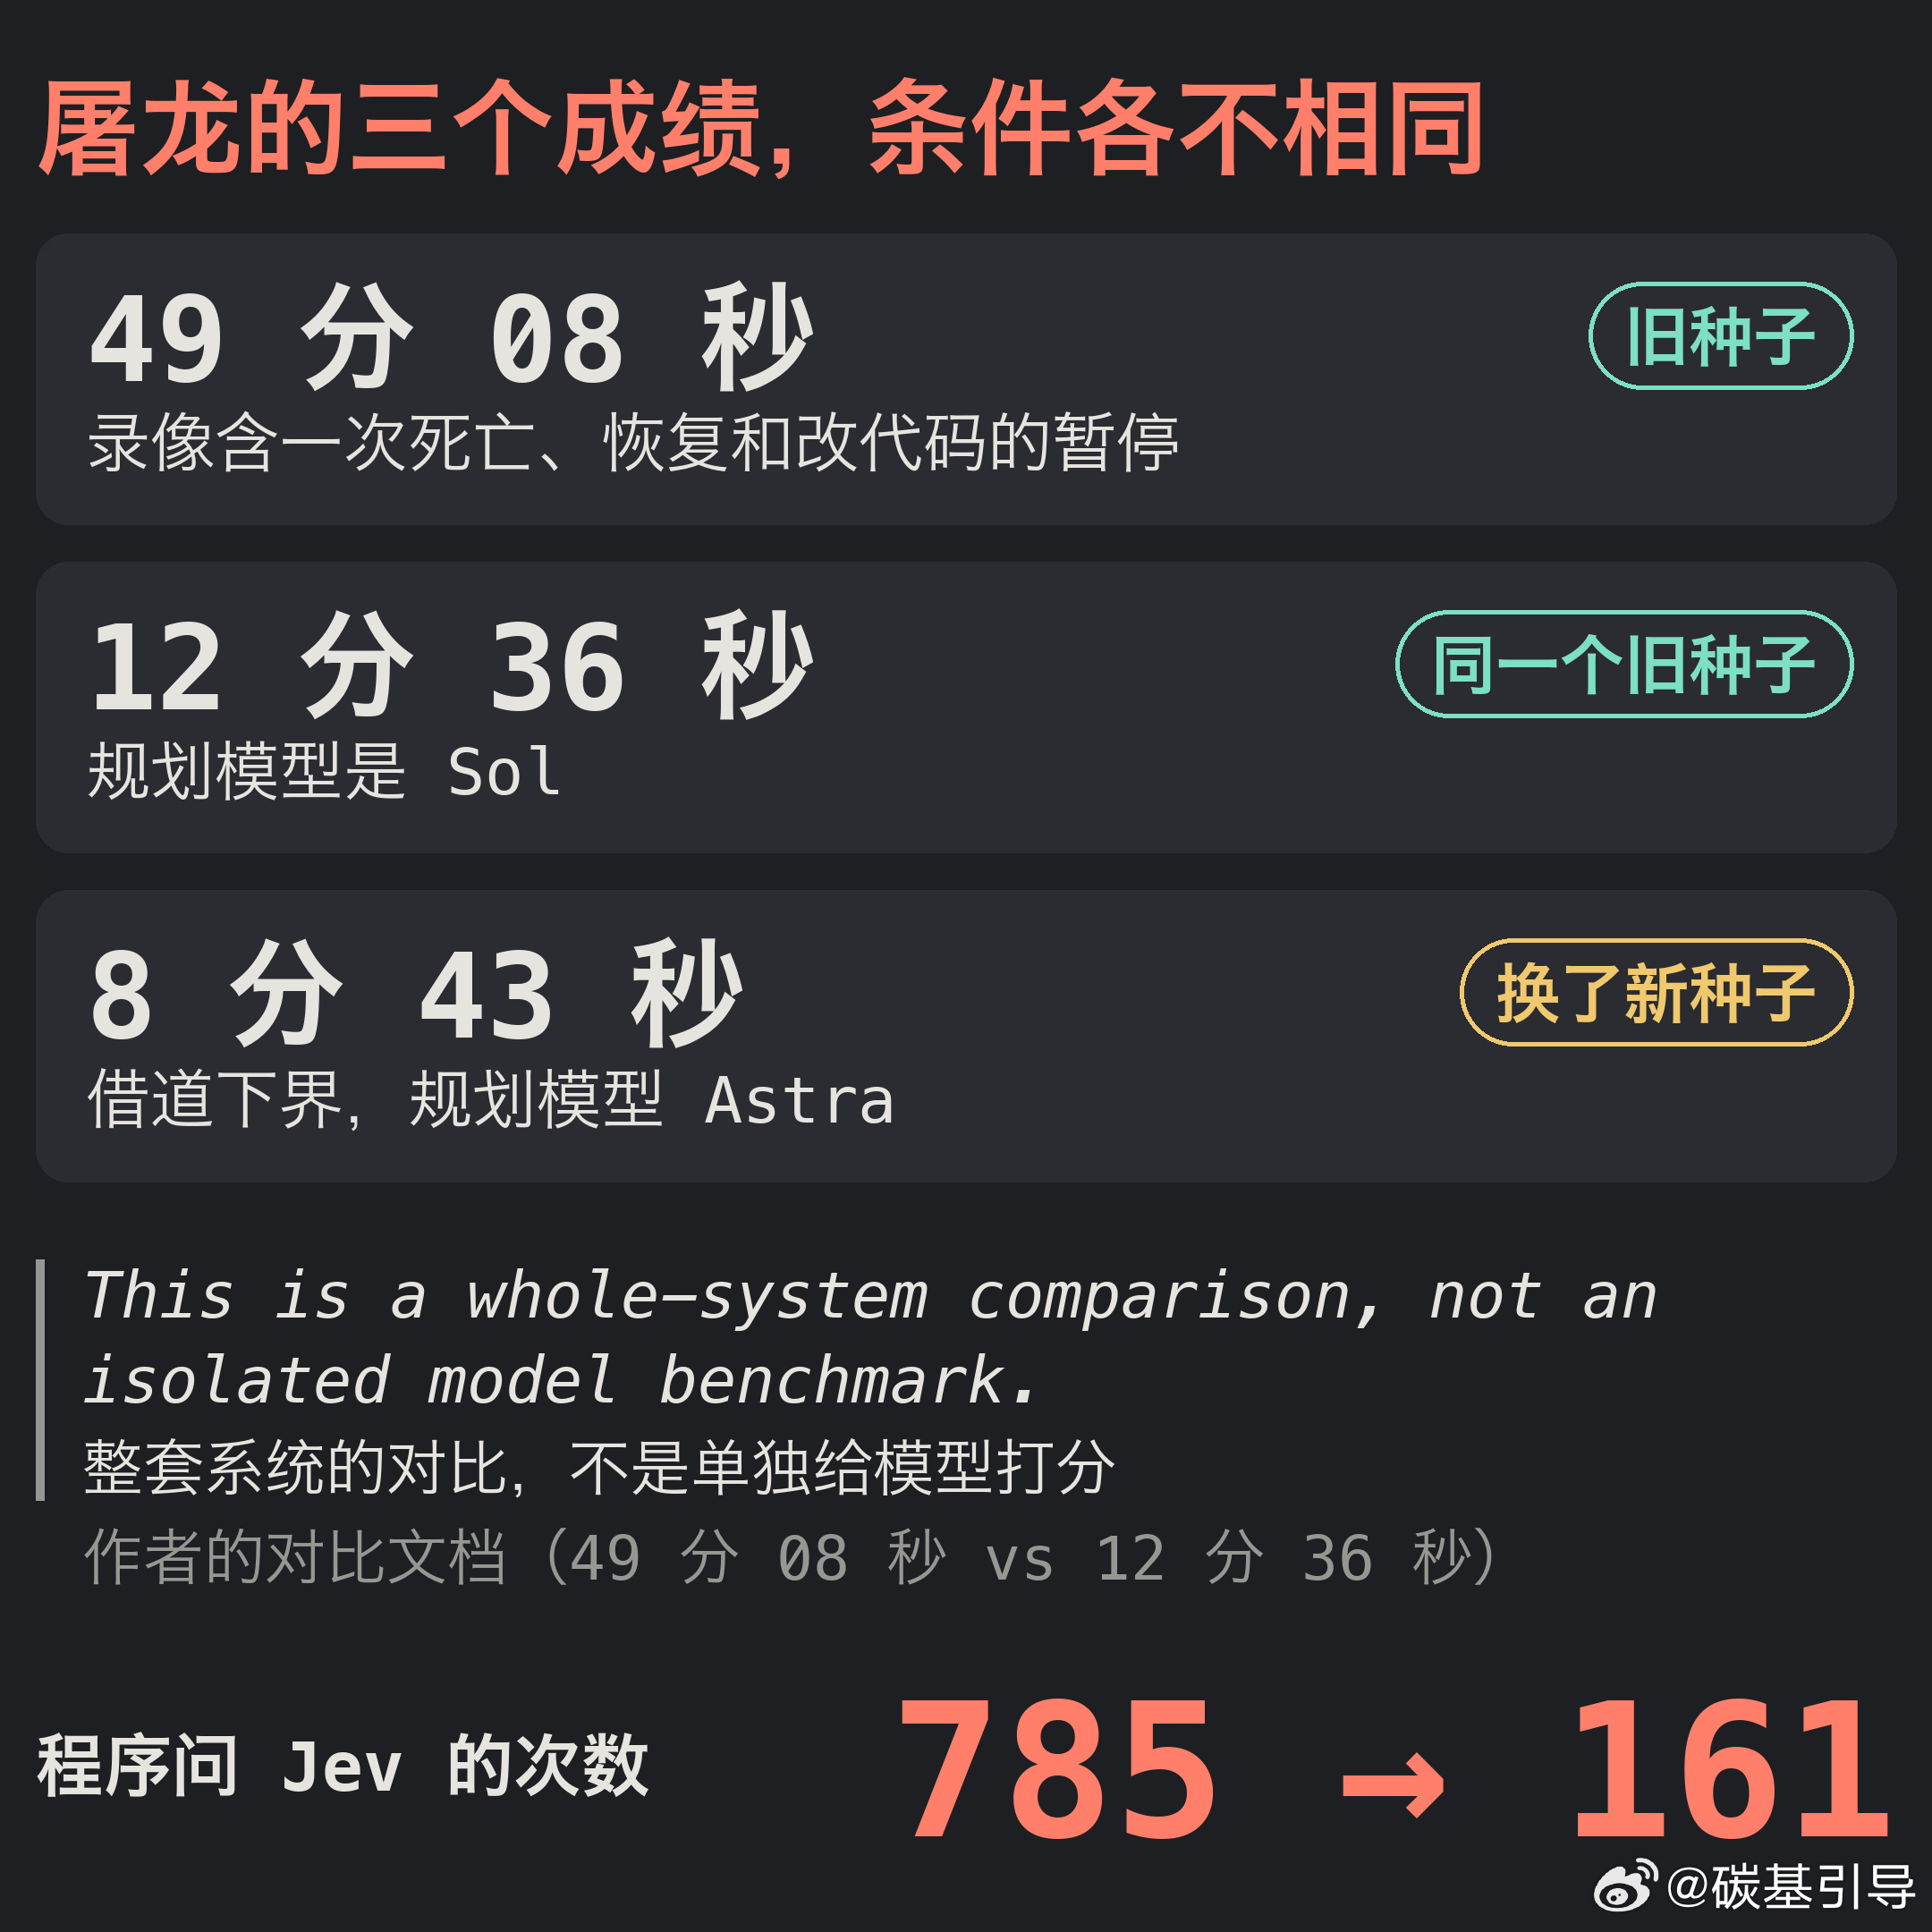
2️⃣ 屠龙的三个成绩 49 分钟、12 分 36 秒、8 分 43 秒,条件各不相同,不能连起来看成 Jev 的进步。49 分钟那份录像里有作者中途暂停、更新代码的片段,这局是边跑边打补丁。作者的校验脚本还注明,中途改过一份写给模型看的文字指示,规划模型和 Jev 都会收到。12 分 36 秒那局,负责规划的是 Sol,不是推文里的 Astra;8 分 43 秒换了地图种子,改成借道下界。
3️⃣ 作者自己比的也是整套系统,不是 Jev。对比文档原话是 whole-system comparison,列的主要修补都在程序这一侧。49 分钟和 12 分 36 秒两局比下来,程序问 Jev 的次数从 785 降到 161。
马里奥和 Doom 也看不到边玩边学。马里奥项目里,连「这一步必须起跳」都由代码先算好;官方 Doom 演示的博客和视频里,也没提把历史或失败记录交给 Jev。
社区里真把失败经历喂给 Jev 的项目,我们找到的寥寥几个,效果都没立住。比如一个贪吃蛇项目,每局把死前几步交给 Jev,让它从规则库里选一条写进指示。第一轮选中的规则让分数减半,没过作者自己的检验。
不过,这些都不等于 Jev 学不会。那 Jev 到底能不能边玩边学?下一篇我们自己测。
Jev人工智能