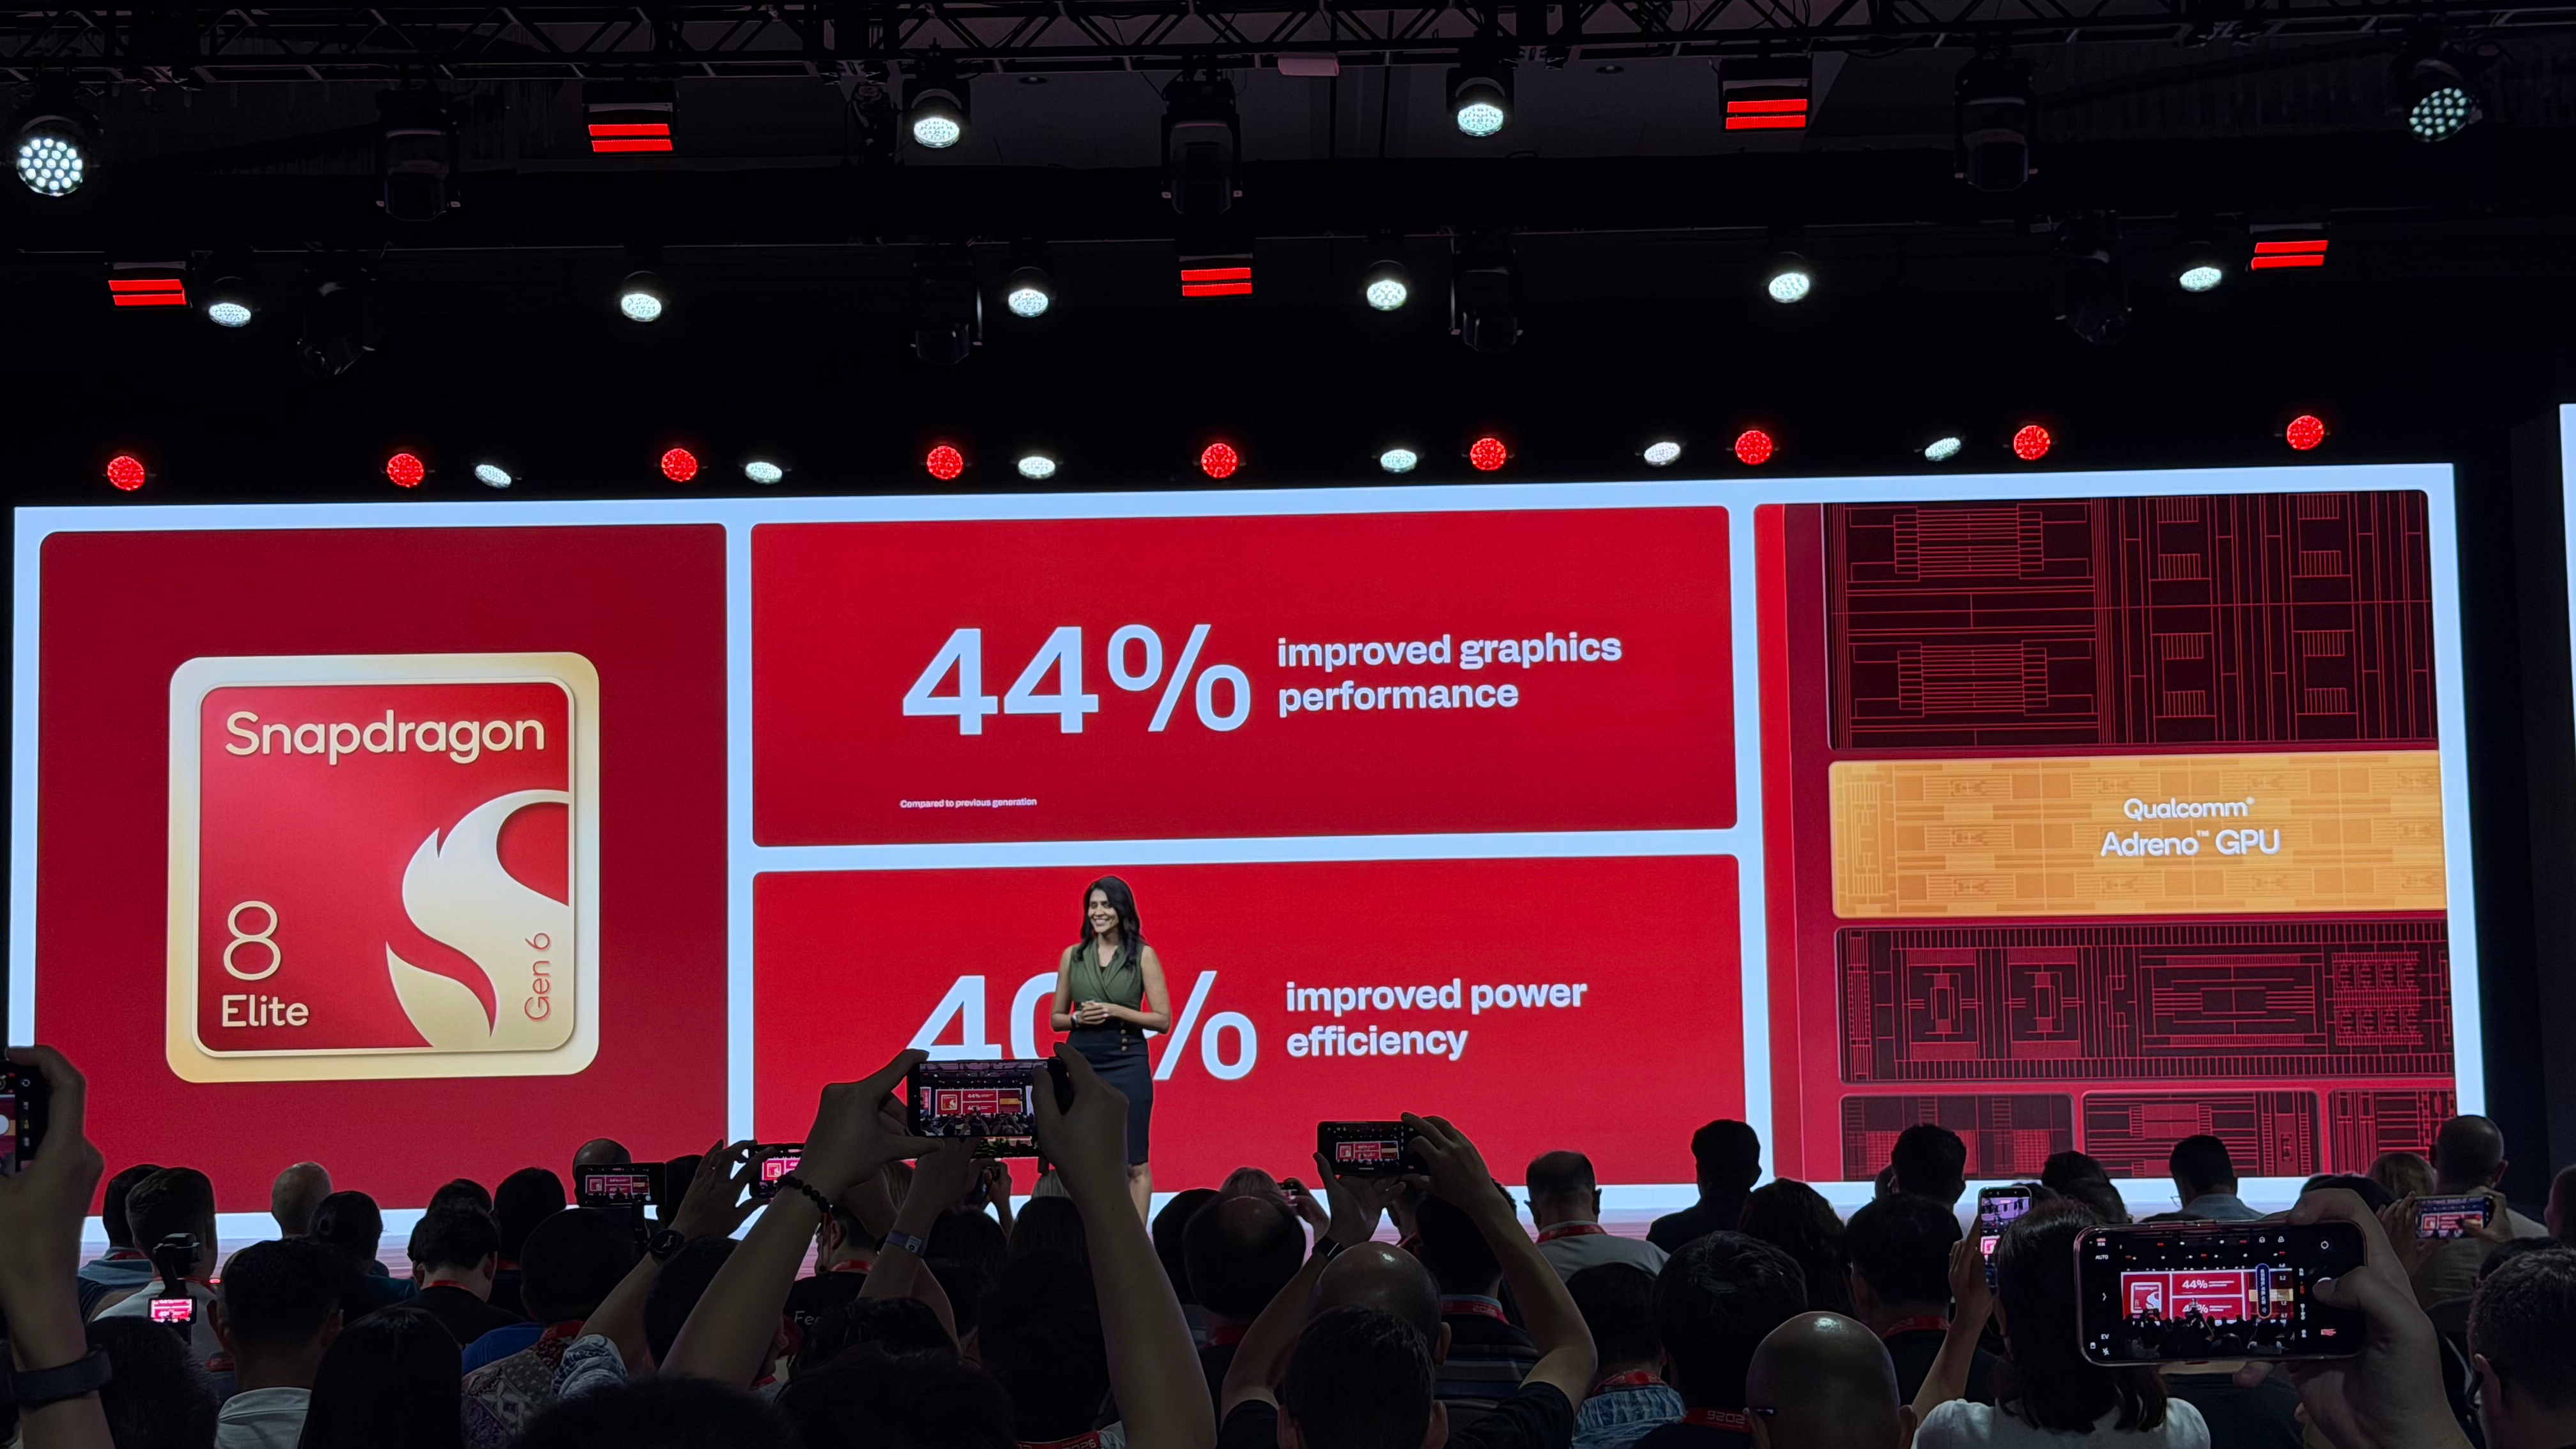
高通刚刚正式发布了第六代骁龙8超级至尊版 和第六代骁龙 8 至尊版,两款全新的旗舰移动平台,我们主要来聊其中代表骁龙创新巅峰的第六代骁龙 8 超级至尊版。骁龙峰会
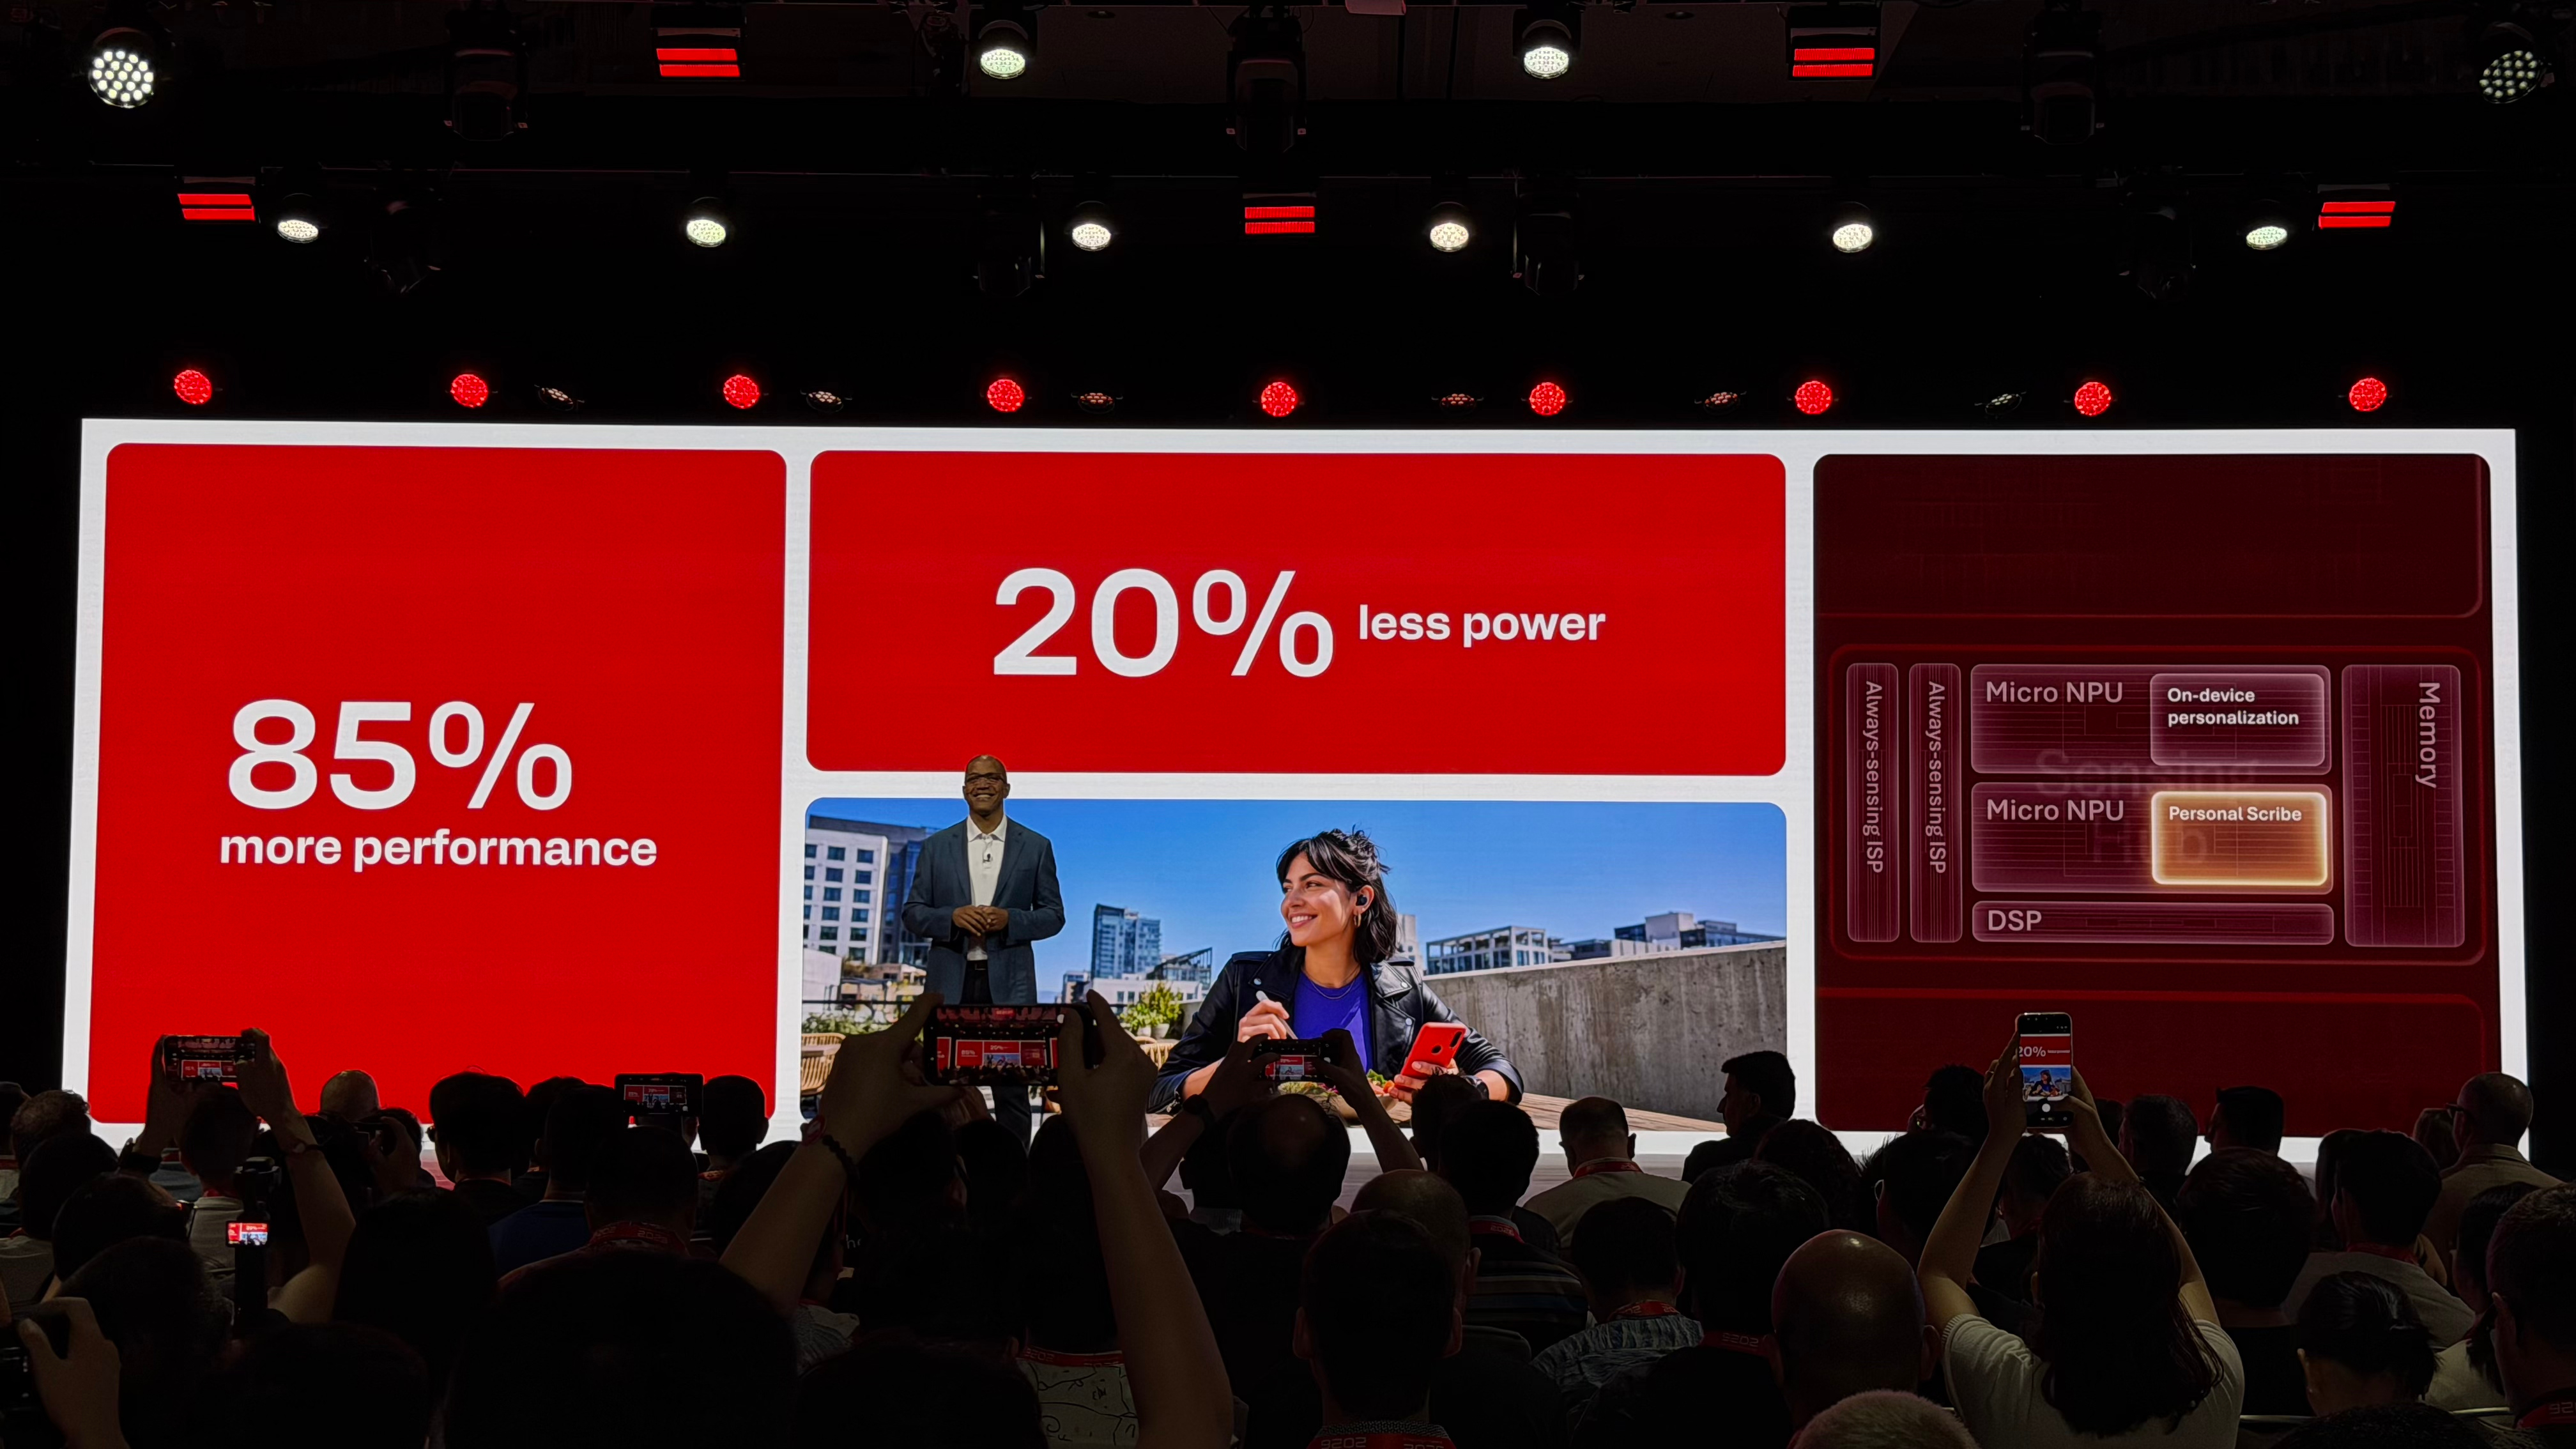
先看性能,这一代升级还是很明显的。
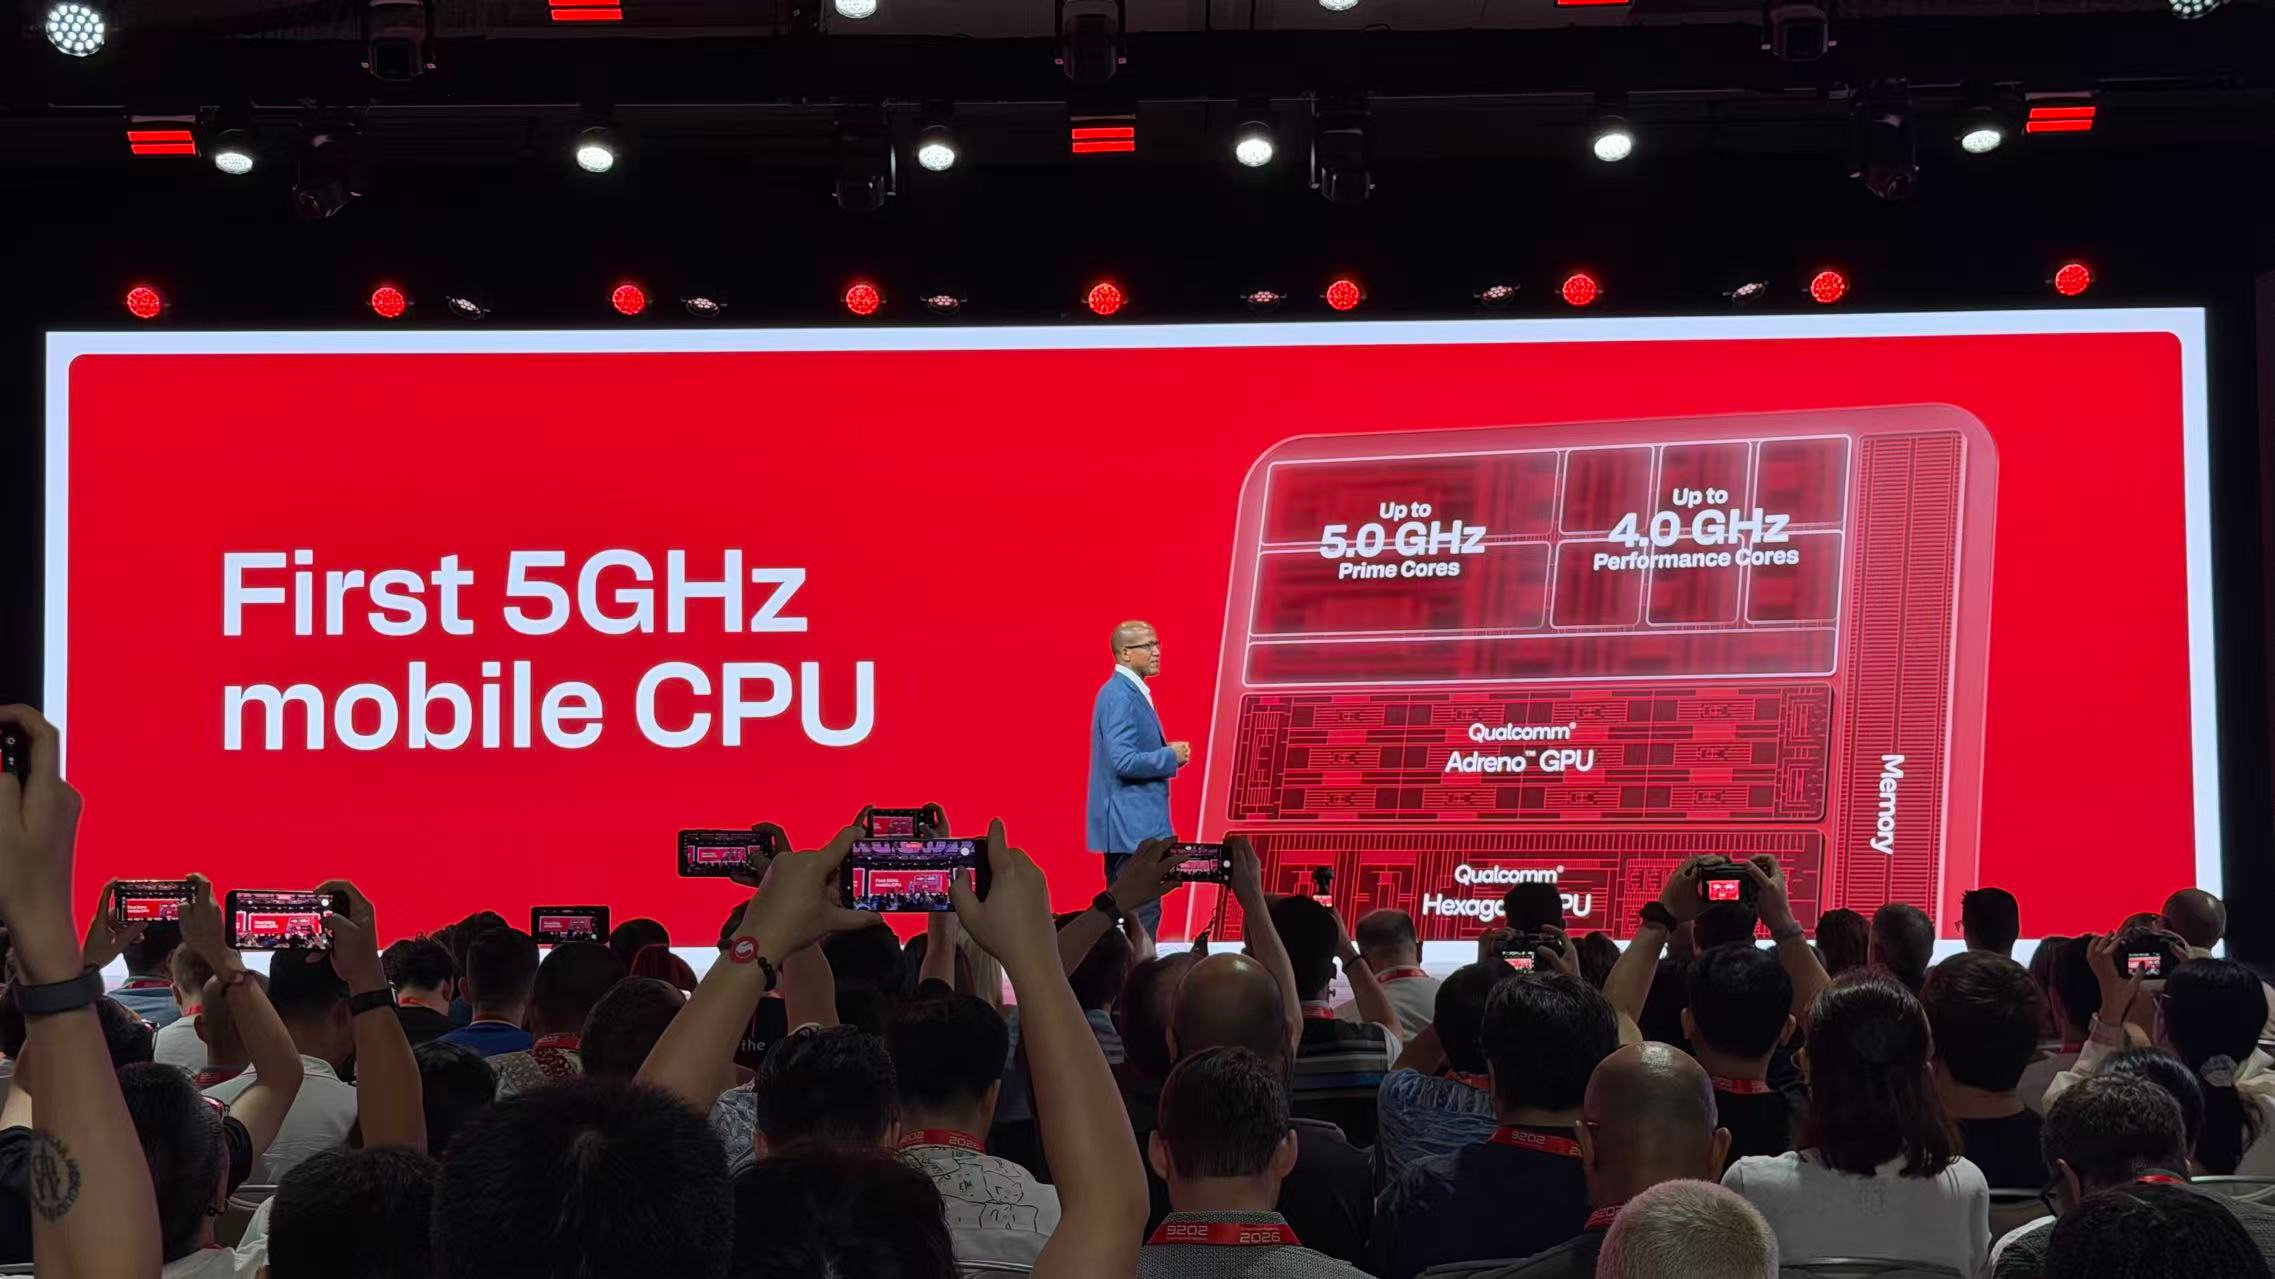
全新的 Qualcomm Oryon CPU,让移动端 CPU 的最高主频第一次来到 5GHz,同时加入 Oryon FlexCache。它可以让不同计算核心共享一个动态分配的缓存池,让需要的数据尽量留在缓存里,减少频繁访问系统内存。放到实际体验里,不管是连续打开大型 App、修完图马上剪视频,还是游戏过程中处理后台任务,复杂任务之间的切换都会更流畅。
GPU 提升也很大,新的 Qualcomm Adreno GPU 加入了 Adreno Neural Fusion,把神经网络处理、AI 超级分辨率和 AI 帧生成放进同一套图形管线,同时还有新的 Adreno Matrix Cores 专门处理 AI 工作负载。简单来说,以后游戏想获得更高的分辨率和帧率,不一定只能靠 GPU 硬算,AI 超分和 AI 插帧也会越来越多地参与进来。对于用户来说,最终就是画面更清楚、体验更流畅,同时功耗也更低。
但这次在峰会现场,我觉得还有一个变化更加明显——AI 在整个平台里的位置已经完全不一样了。
第六代骁龙 8 超级至尊版本身就是面向智能体 AI 时代设计的。从 CPU、NPU 到 GPU,核心计算引擎都有 AI 加速能力,再加上缓存和存储架构的变化,让计算、AI 和图形处理能够更好地协同起来。
过去我们说手机 AI,很多时候还是一个功能对应一个入口,比如 AI 修图、AI 总结、AI 问答。但现在高通想做的,是从感知、记忆、计算、调度一直到连接,让整个平台都围绕 AI 来工作。
高通对这一阶段的定义叫做智能体时代。AI 不再只是等着你提出一个问题,然后给出答案,而是逐渐能够理解你的意图和上下文,再调用不同能力去完成一整套任务。
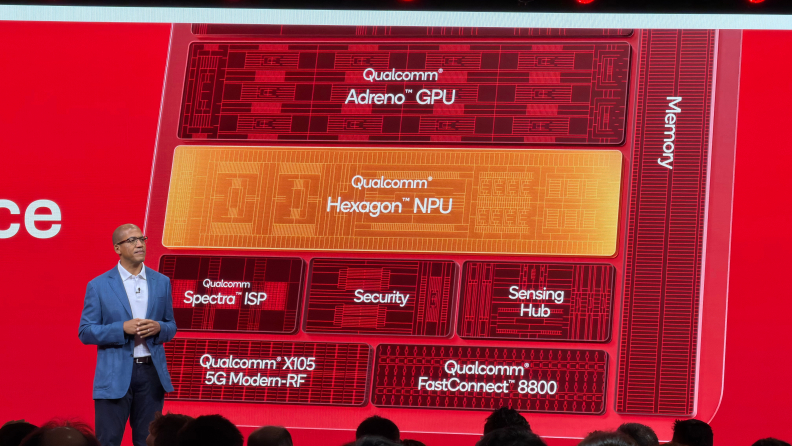
这也是这次 Hexagon NPU 升级很重要的原因。
新的 Hexagon NPU 针对 Transformer 工作负载加入了 Element Accelerator,同时扩大共享内存,让模型状态、上下文和 KV-cache 尽可能在更靠近计算单元的位置。简单理解,就是当手机上的 AI 需要记住更多信息、理解前后文,再连续处理多个任务的时候,可以更高效地完成这些计算。
而当 AI 开始接触邮件、日历、照片、文档甚至行程之后,本地计算的重要性也会越来越高。一方面响应更快,对网络依赖更低;另一方面,很多个人信息也可以直接留在手机里处理,不需要频繁上传到云端。
今年峰会上有一个我印象很深的展示,就是高通联合阶跃、无量火和江波龙,把 StepEdge-Omni 30B-MoE 模型完整部署到了第六代骁龙 8 超级至尊版上。
现场这个智能体可以直接在本地完成邮件理解、行程规划、日历同步、航班酒店推荐,再到邮件草拟的一整套流程,核心模型推理与智能体工作流可在终端侧完成。模型预填充吞吐超过 330 Token/s,解码吞吐超过 28 Token/s。它证明了手机开始有能力把一整套任务真正串起来,同时还能保持比较流畅的使用体验。
所以看完今年的骁龙峰会,我对第六代骁龙 8 超级至尊版最大的感受是,性能依然是它最扎实的基本盘,但 AI 已经不再只是芯片里额外加进来的一个能力,而是在更深地参与整个移动平台的设计。
从 CPU、GPU 到 NPU,再到缓存、存储和连接,这些升级最后都指向同一个方向:让 AI 智能体真正参与到手机的使用过程中。性能变强只是基础,更重要的是让手机能理解信息、处理任务、串联流程,让我们用手机这件事本身变得更高效,也让手机真正开始向新一代智能终端演进。
接下来一批搭载第六代骁龙 8 超级至尊版的新机应该也很快就会陆续和大家见面。如果最近准备换旗舰手机,我会比较期待这些新品。除了看看性能、影像和续航,我更想看看不同厂商拿到这一代平台之后,能不能真的把这些底层 AI 能力,做成每天都用得到的体验。