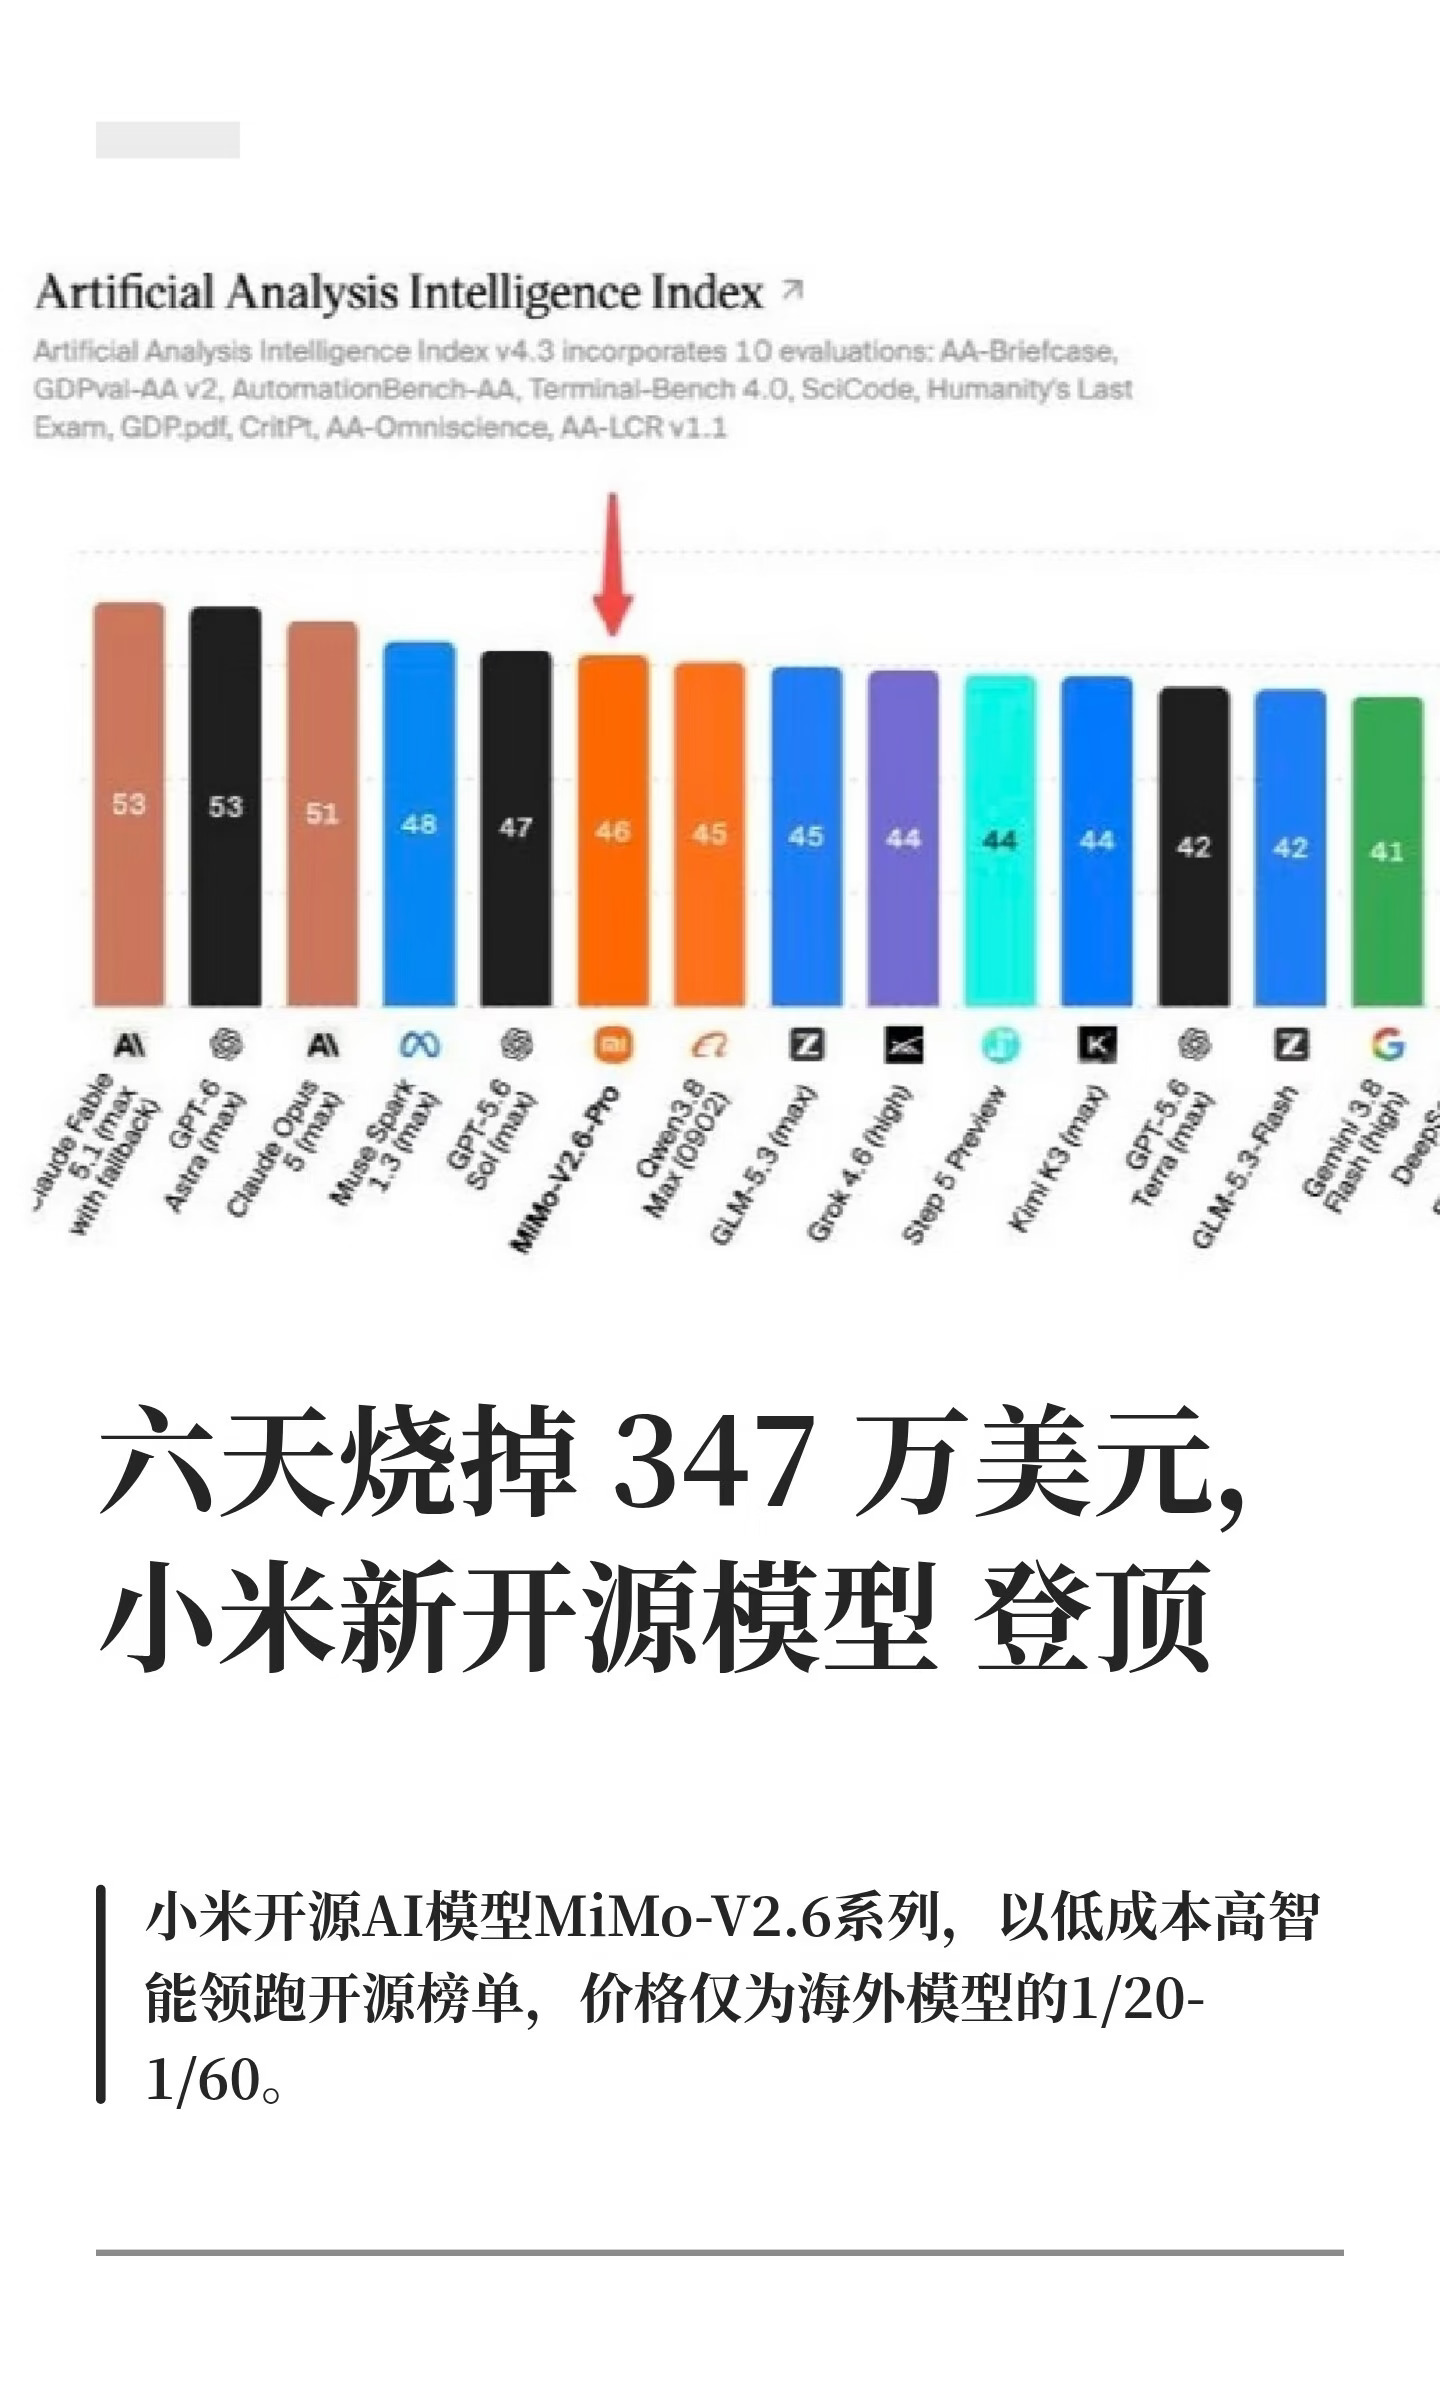
小米把AI模型的斩杀线,又往下砍了一刀。
MiMo-V2.6系列正式发布并开源。Pro版本在Artificial Analysis Intelligence Index v4.3拿下46.32分,超过Kimi K3和Qwen3.8 Max,小米称其为当前榜单得分最高的开源模型。
但比分数更狠的是背后的账本。
六天烧掉347万美元。
Flash和Pro各自完成30个强化学习step,各产生约75万条训练轨迹,成本分别约85万和262万美元。每个step包含1568个prompt,每个prompt同时生成16条候选轨迹,一次处理约2.5万条长序列和27亿到37亿训练token,最长上下文达到100万token。
罗福莉在发布后把这件事称为“扩展RL的艰难之路”。她说按算力投入衡量,这很可能是开源模型团队迄今规模最大的单次强化学习训练之一。在她看来,MiMo-V2.6背后的研究创新和工程难度,甚至超过她曾部分参与的DeepSeek R1。
成绩单摊开看。
DeepSWE v1.1拿下71.9分,接近DeepSeek V4.1 Flash的74.2和Claude Opus 5的74.0。Toolathlon-verified 76.9分,高于GPT 5.6 Sol的74.9。JobBench真实职业任务62.0分,仅次于Claude Opus 5的65.7。网页与可视化生成,Pro和Flash分别拿到72.3和71.5,高于DeepSeek V4.1 Flash和Claude Opus 5。
差距也有。Terminal Bench 4.0只拿到34.9分,GPT 6 Astra是59.6,Claude Fable 5.1是55.1。网络安全评测整体落后头部闭源模型。
但真正要命的是价格。
Flash缓存命中输入每百万token 0.02元,普通输入1元,输出2元。Pro分别是0.025元、3元、6元。同等智能水平下,MiMo-V2.6系列价格仅为海外模型的1/20到1/60。
罗福莉还解释了MixRL和MOPD的分工:代码等可验证任务进MixRL获得跨任务迁移能力,游戏、3D、超长链路等主观任务分别训练,再通过MOPD合并回主模型。扁平的团队结构降低了组织成本。
小米开放的也不只是模型权重。训练曲线、奖励机制、任务配比、关键参数、成本构成全部写进技术报告,还发布了约7000个RL任务环境、验证器和训练框架。
能力和价格同时压到这个位置,竞争压力转向了价格更高的一方。它们需要证明,多出来的溢价到底能换来什么。
#人工智能 #科技 #科技资讯早知道 #ai #大模型