关注到:小米 MiMo-V2.6 系列正式发布。
相比于v2.5,这次的升级主要是体现在了多模态、tps、强化学习带来的智能提升,开源最强,——以及帕累托前沿的性能
目前来看,v2.6还是在之前v2系列上进行的续训,没有更换基础的模型,
Pro 还是约 1T 总参数,稀疏 MoE 大约 1.02T 总量、42B 激活;Flash 还是约 300B,309B 总量、15B 激活。上下文依旧是 1M token,架构继续走混合注意力(滑窗加全局),外加原生多模态编码器。
大家想要的大版本更新,可能还是要等年底的v3系列。
这半年以来,小米虽然没有更新新模型,但是显然也是没有闲着。而是把算力和心思砸进了高质量数据、强化学习环境和研究本身。
速度上,这次体验里最直观的变化是 TPS 比之前高很多,核心受益于对 DFlash MTP 的支持。简单来说:V2.6 的 Multi-Token Prediction 草稿器是 5 层 SWA 结构,一次前向可以多预测后续 7 个 token,再做并行验证。上一代 MTP 大约是 3 层,草稿接受率上来了,解码自然就快。
Artificial Analysis 独立测得 MiMo-V2.6-Pro 输出约 129.7 tokens/s,四舍五入130 TPS。作为对照,目前glm5.3的速度大概是60,kimik3在50以内。
同一质量档位下还有 Pro-UltraSpeed,官方口径最高可达 Pro 的 20 倍输出速度,这个是加入了量化的版本,价格也是贵很多。
Flash 本身就是效率取向的 300B 档,再叠上这代 5 层 DFlash MTP,速度应该也是比之前更快的。之前v2.5就让人5用起来便宜,这次智能更高了,应该更爽一些。
多模态这边,V2.5 时代有个遗憾:小杯 Flash 反而是全模态,大杯 Pro 主打文本。这次补齐了——Pro 同样是全模态输入,文本、图片、视频、音频都能输入。
多模态还是很美丽的一个东西,能用的地方确实很多。代码 agent 可以看截图改 UI、读视频做演示、听录音整理需求。
在官方的宣传片里这次还秀了 3D 建模、具身仿真、前端设计、视频剪辑,甚至写管弦乐 MIDI的场景——多模态不再只是能识图,而是进了生产流。
当然听了一下midi生成,基本处于一个没法听的状态(但是只要能scaling,这种事情不是向来很快的吗)相比于suno之流的扩散生成,用语言模型+computeruse做到的可能更具解释性一些。
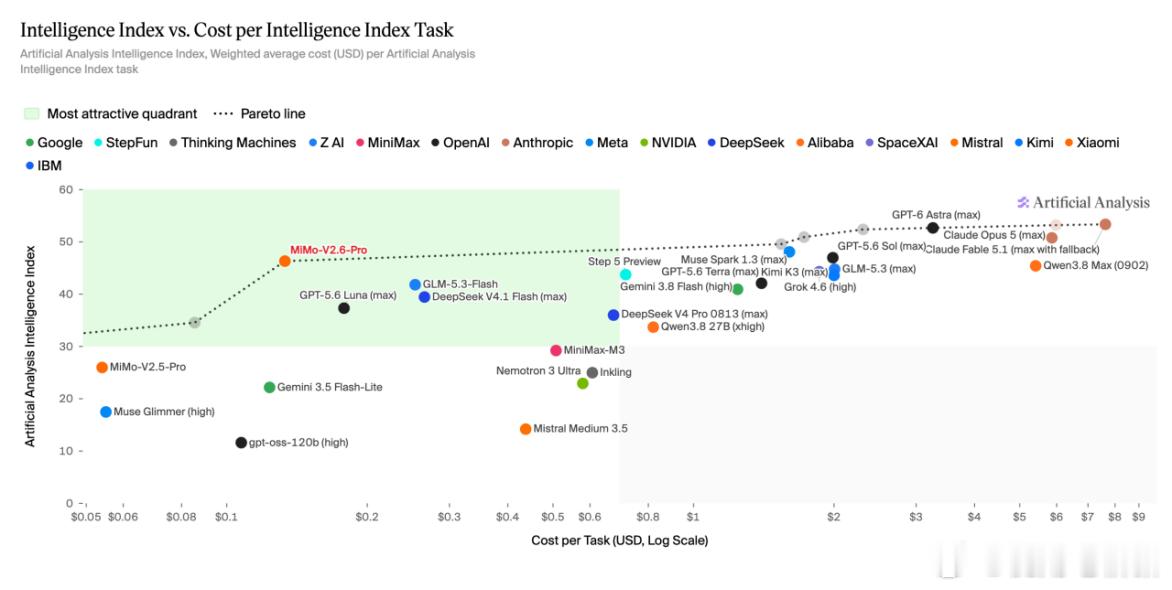
在 Artificial Analysis 上,MiMo-V2.6-Pro 的智能指数到了 46.32,超过 Kimi K3、GLM 等开源对手,成为目前开源模型里的最高分。
目前aa给到到这个分数,是一个把多项独立评测揉在一起的综合指数,v4.3 一批里有 AA-Briefcase、GDPval-AA、Agentic、Coding 等十项。最后是通过多项任务的综合表现来打分的。46 意味着在开源阵营里,已经摸到了相当靠前的位置
V2.5 发布到现在,差不多过去半年。这半年如果只看版本号,会觉得小米在摆烂。但是v2.6的成绩一上来,大家又会发现小米的人确实没闲着——相比于刷版本号,把时间精力和资源放在一个月训练一次上,小米更愿意想方设法造高质量数据、把强化学习环境做扎实、做好基建的研究。
想起来今年年初的时候,罗福莉接受访谈,说未来的算力分布可能是做研究三分之一、RL 三分之一、预训练三分之一,未来可能 RL 的占比还会更高。现在回头看 V2.6 ,几乎就是照着这个方向推进的。
把增量全部押在可验证复杂任务上的规模化 RL,以及支撑 RL 的环境、评分器、数据管线。所谓自我改进(RSI)路线,核心就是:探索、反馈、再扩展能力边界。所以权重没变不是保守,而是资源分配的结果。当
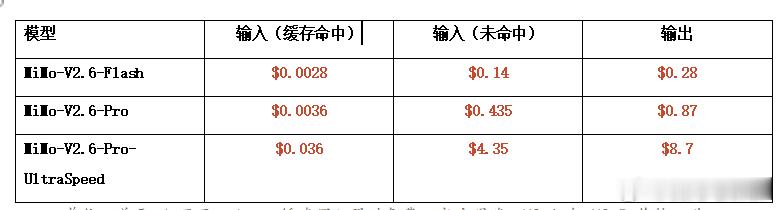
接下来是这次发布非常关键的一点:性价比极高。相对 V2.5,API 价格没有涨。这个价位,仍然是deepseekv4preview那个随便爽用的价格区间。
模型 输入(缓存命中) 输入(未命中) 输出MiMo-V2.6-Flash $0.0028 $0.14 $0.28MiMo-V2.6-Pro $0.0036 $0.435 $0.87MiMo-V2.6-Pro-UltraSpeed $0.036 $4.35 $8.7
相比之下,DeepSeek 这边已经开始玩起了梁文锋、梁文谷——峰谷两套价,忙时闲时两个世界。
能力*价格,实际上就是ai领域的帕累托前沿。
评价一个模型,我最看重的就是这条线:同等能力下,没有比你更便宜的;同等价格下,没有比你更强的。
通俗说,它也可以叫斩杀线——不在这条前沿上的东西,没有使用的理由。大家为什么要花更多的钱买更差的?除非你是包年的 Plan 用户,有沉没成本。当然你也可以引入更多特性,用更符合我个人需求来论证使用价值,评价方式可以多元——但这并不妨碍帕累托前沿的参考价值。
当然,现在对于小米来说还有一次大考,就是如何承接这个高频的服务需求。当你做到帕累托前沿的时候,喜欢性价比或者喜欢绝对智力的用户就开始群殴你了。就像deepseek也扛不住这个算力需求,连续几次崩了之后只能是给用户涨价来限制。
不过好在,小米这边暂时不是很担心能不能把服务扛住的问题——背后站的是金山云,没卡了可以租。这
对于服务商来说,比较难解决的就是供应链与成本结构问题。模型公司怕的不是流量峰值,是峰值来了手里没有可控算力。
现在有金山云这条腿,扩容路径是清晰的;再叠上 Token Plan 这种包量产品,对高频用户和对服务方都更稳。
据说年底金山云的 B 卡集群也会到位。到那时候,训练侧的资源会更充足足,V3 系列值得期待。
小米这次玩的花活,叫直播进行强化学习。把生产级 RL 跑线过程开着直播,让大家看见它在训练打榜。
两款模型分别进行了 30 步的 RL。花费了 5 天时间 300 多万美元——具体拆开看:Flash 约 0.85M 美元,Pro 约 2.62M 美元,加起来大约 3.47M 美元。
轨迹规模约 75 万条量级,大批次、全异步 GRPO,每步能烧到十亿级 token。
据小米自己介绍,这套管线是通过对于开源的项目分析之后,自动生成的任务处理环境。通过现实的项目来评价强化学习当中每一步的奖励,使它能够更好地收敛在更高的水平。
小米还把不同的任务合并成统一批次的强化学习。代码、通用 agent、视觉、网安这些任务一次训完,不会把它拆解分批次进行(应该也是避免灾难性遗忘的一种玩法?)
同时还进行组内的Creditor打分,光有通过、不通过不够,还要在组内比谁解得更好,把优势重新分配给更高质量的轨迹;以及一整套防 reward hacking 的对抗筛选和交叉校验。过程里还冻结了 router,解决训练漂移的问题。
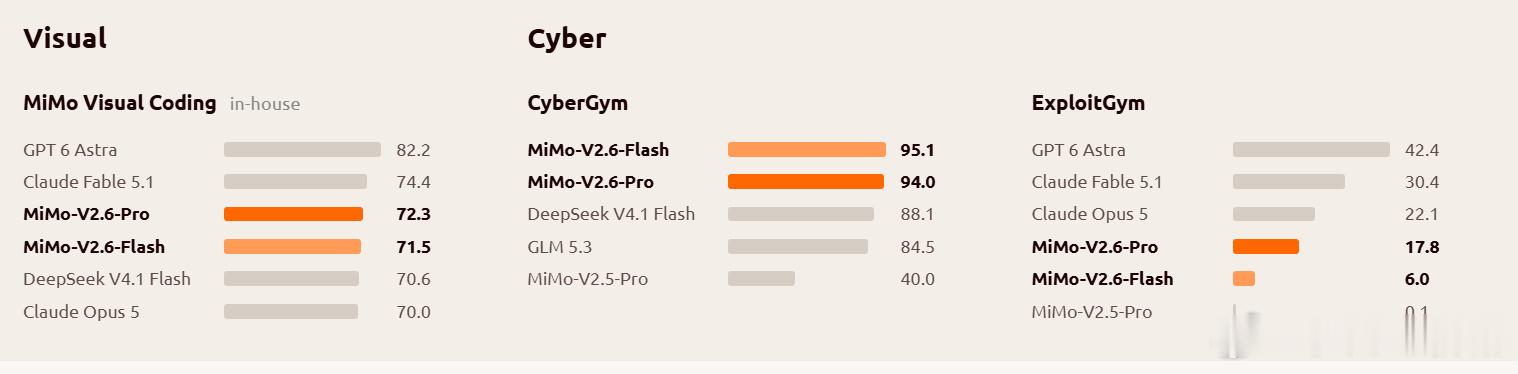
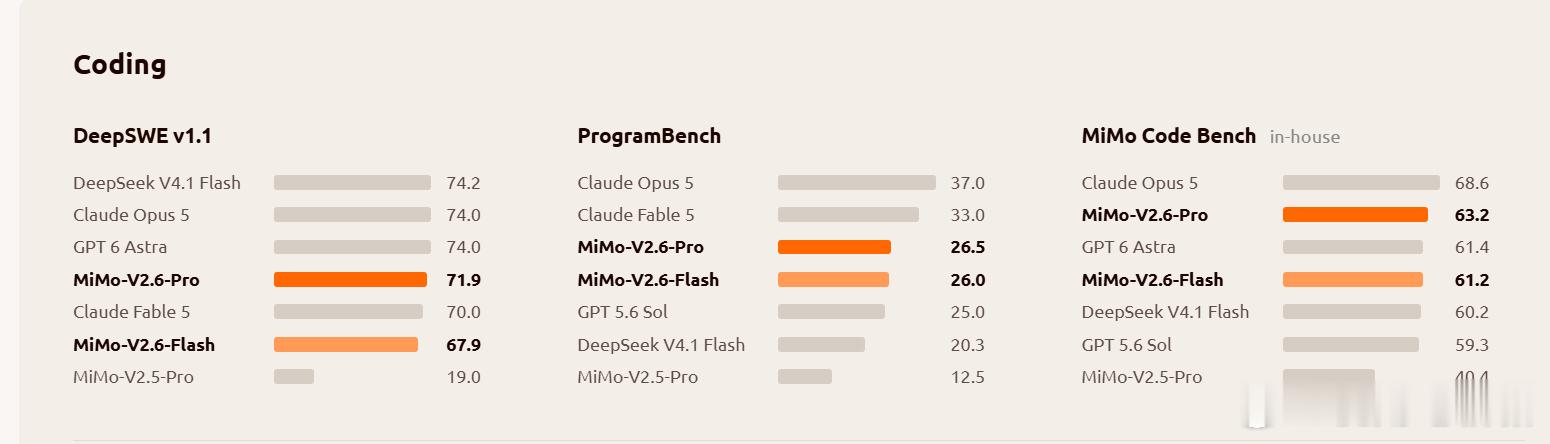
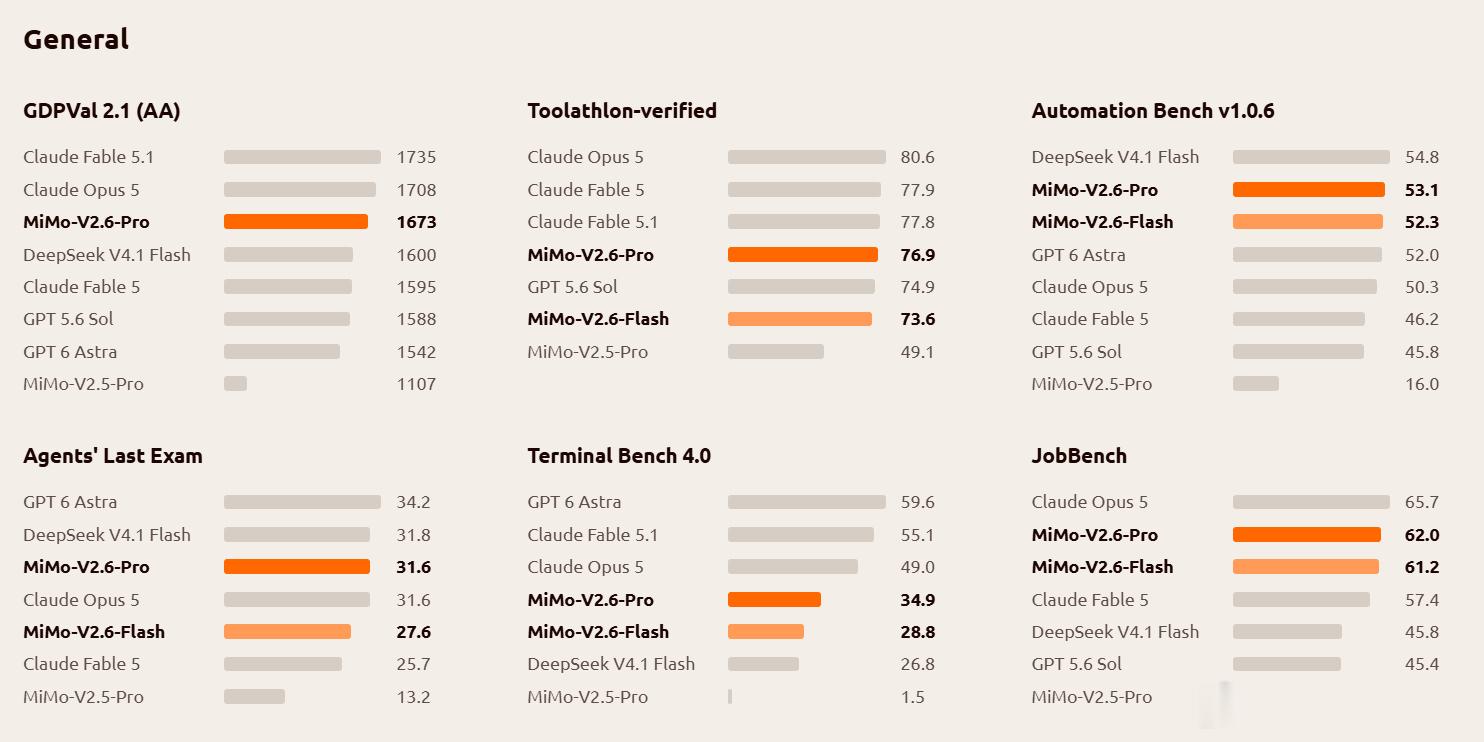
然后是一些喜闻乐见的跑分环节,基本上来看,小米这次可以是完全竞争开源第一的水平,不是竞争“第一梯队”。不过相比于gpt astra,Claudefable这种财大气粗启动早数据多资源足的对手来说,还是有一定差距的。
当然,这个时候可能又有人说,这是什么洋人之下我第一,闭源之下我第一。又有人说,高分低能,只会刷分,把分刷那么高有什么用?
但是很可惜的是,现实它就是一个这些并不以人的精神幻想而转移的地方,
如果真的不如别人,那么承认就是最好的自我认识。正是因为我们认识到自身的缺陷、不足、差距,有待优化的场景,用更加全面、客观、准确的评价方式来校准自身,才能不断地前进。
这些测试集无非就是用来自我标定、自我测试的方式,现在的测试集也都很聪明,你能想到的刷分方式,也都在越来越严格的限制。
如果你对某一个场景过拟合,那么可以说你是有问题的。但是如果你对所有场景过拟合,那就叫泛化。
至于刷分有没有用:对科研社区,公开基准是共同语言;对采购方,分数只是初筛,最终要看你自己的场景跑分。两条路径并不互相否定。真正没用的,是既拿不出分数,又交不出场景交付物,只好靠解构分数无意义来找补。
当然,我们可以继续未来可期一下。以目前的这个价格来说,性价比是很强的,应该会获得一些质量较高的使用数据可以更进一步地开展 RL。
据说年底,金山云的 B 卡集群也会到位。可以期待一下 V3 系列的表现。
评价模型,说到底还是那句:同等能力谁更便宜,同等价格谁更强。其余的,都是包年用户的故事,或者非常合理的个人偏好了