这次轮到中国“定规矩”了。
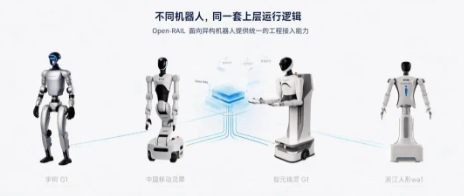
9月16日,中国移动干了一件大事,正式宣布向全球开源了Open-RAIL,这是行业内第一个把VLA/WAM模型和机器人本体连起来的通用工程底座。
很多人看到这里可能一头雾水:这东西又不是新机器人,也不是新的人工智能大模型,有什么值得关注的?恰恰因为它既不是“大脑”,也不是“身体”,事情才有意思。
现在具身智能行业有一个很现实的问题:会思考的模型越来越多,会走路、会抓东西的机器人也越来越多,但两边往往“语言不通”。
一台机器人一种关节定义,一家公司一种通信协议,不同型号坐标系、控制频率、数据格式都可能不同。换个机器人,工程师可能就得重新改一遍接口;换个模型,又要重新搭一遍推理链路。
说得接地气一点,现在不少机器人多少有点“一机一个脾气”。大模型明明已经学会了怎么干活,到了真机这里,还得先找个程序员给它当“翻译”。Open-RAIL干的,就是把这层翻译系统尽量统一起来。
它在模型和机器人之间增加了一套通用连接层,把模型推理、机器人执行、运行数据采集、效果评估,再到下一轮模型训练串成一个闭环。
首个公开版本已经适配4类异构机器人,支持10个主流VLA/WAM模型。以后增加一个新模型,按照项目设计,通常只需要50到100行左右的适配代码;新机器人接入,也从过去可能按周计算,压缩到按小时计算。
这看起来像程序员少写了几天代码,实际上背后涉及的是整个具身智能产业的成本。机器人真正商业化,最怕的不是实验室里做不出Demo,而是每换一款硬件都要重新开发,每落地一个场景都要重新搭系统。
项目做十台还能靠工程师硬扛,未来如果是十万台、百万台,这种玩法根本扛不住。Open-RAIL还有一个很关键的设计,就是把“大模型慢、机器人快”这个矛盾拆开。
VLA模型一次推理往往只有5到10Hz,而机器人电机控制可以达到200Hz以上,甚至更高。一个在慢慢想,一个要求手脚高速执行,如果硬绑在一起,机器人就容易出现停顿、抖动甚至动作不连贯。
Open-RAIL通过观察、推理、控制三个线程异步运行,再配合两级轨迹平滑,让机器人不用傻等模型每一次推理完成。
项目给出的测试结果中,机器人关节加速度标准差可以从10+rad/s²降到0.1rad/s²,下降约两个数量级。翻译成人话就是:机器人不光得“知道怎么做”,还得真正把动作做顺,不能端杯咖啡的时候像手里装了个振动马达。
更值得注意的是数据。具身智能目前最贵的东西之一,就是真实世界数据。机器人跑一次、抓一次、失败一次,本来都可以变成训练材料,可现实中数据采集和模型执行经常是两套系统。
Open-RAIL把数据记录直接塞进运行流程。机器人每执行一次任务,图像、关节状态、模型输出和控制信息都可以同步沉淀,继续喂给下一轮训练。
这就形成了一个很有想象力的循环:机器人干活越多,留下的数据越多;数据越多,模型继续迭代;模型变好之后,再回到机器人身上。
这也是我认为Open-RAIL真正值得重视的地方。所谓中国开始“定规矩”,并不是说中国移动发布一个项目,第二天全世界机器人企业就必须照着做。
技术领域真正有生命力的规则,很多时候也不是先靠一纸文件规定出来,而是谁的接口用得多、谁的开发者多、谁的生态跑得起来,谁就可能慢慢变成事实标准。
安卓、Linux,包括大量互联网基础协议,本质上都证明过这一点。而Open-RAIL选择Apache 2.0许可证向全球开放,显然不是准备把这套东西锁在自己院子里玩。
门开得越大,接入的模型、机器人和开发者越多,它作为行业“中间层”的价值才越大。
更有意思的是,中国在具身智能标准化方面本身就在加速。2026年,具身智能操作系统、云协议、数据生成、通用性能测试等一批国家标准项目已经启动,多项具身智能数据相关指导性技术文件也已经发布。
换句话说,一边是正式标准体系往前走,一边是开源工程生态往前跑,两条线正在逐渐靠近。
以前大家聊机器人竞争,最容易盯着谁家的机器人跑得快、谁的大模型参数多。可产业真正进入规模化阶段以后,竞争会越来越往底层走:接口谁来定义,数据用什么格式,模型怎么接机器人,机器人怎么接云端,开发者围绕谁建立生态。
谁能把这些“不性感但必须有人干”的活先干完,谁反而有机会掌握更大的主动权。
所以我看Open-RAIL,最大的价值未必是今天适配了多少机器人,而是中国企业开始主动去修具身智能时代的“公路”和“铁路”。
造一辆最快的车当然重要,但如果路是你铺的、接口是你定义的、越来越多的车都愿意开上来,那影响的就不只是一款产品,而可能是一整个产业生态。
这场具身智能竞争,已经开始从“谁的机器人更会表演”,进入“谁能让千千万万台机器人真正方便地干活”。
而中国移动这次,瞄准的正是后面这件事。