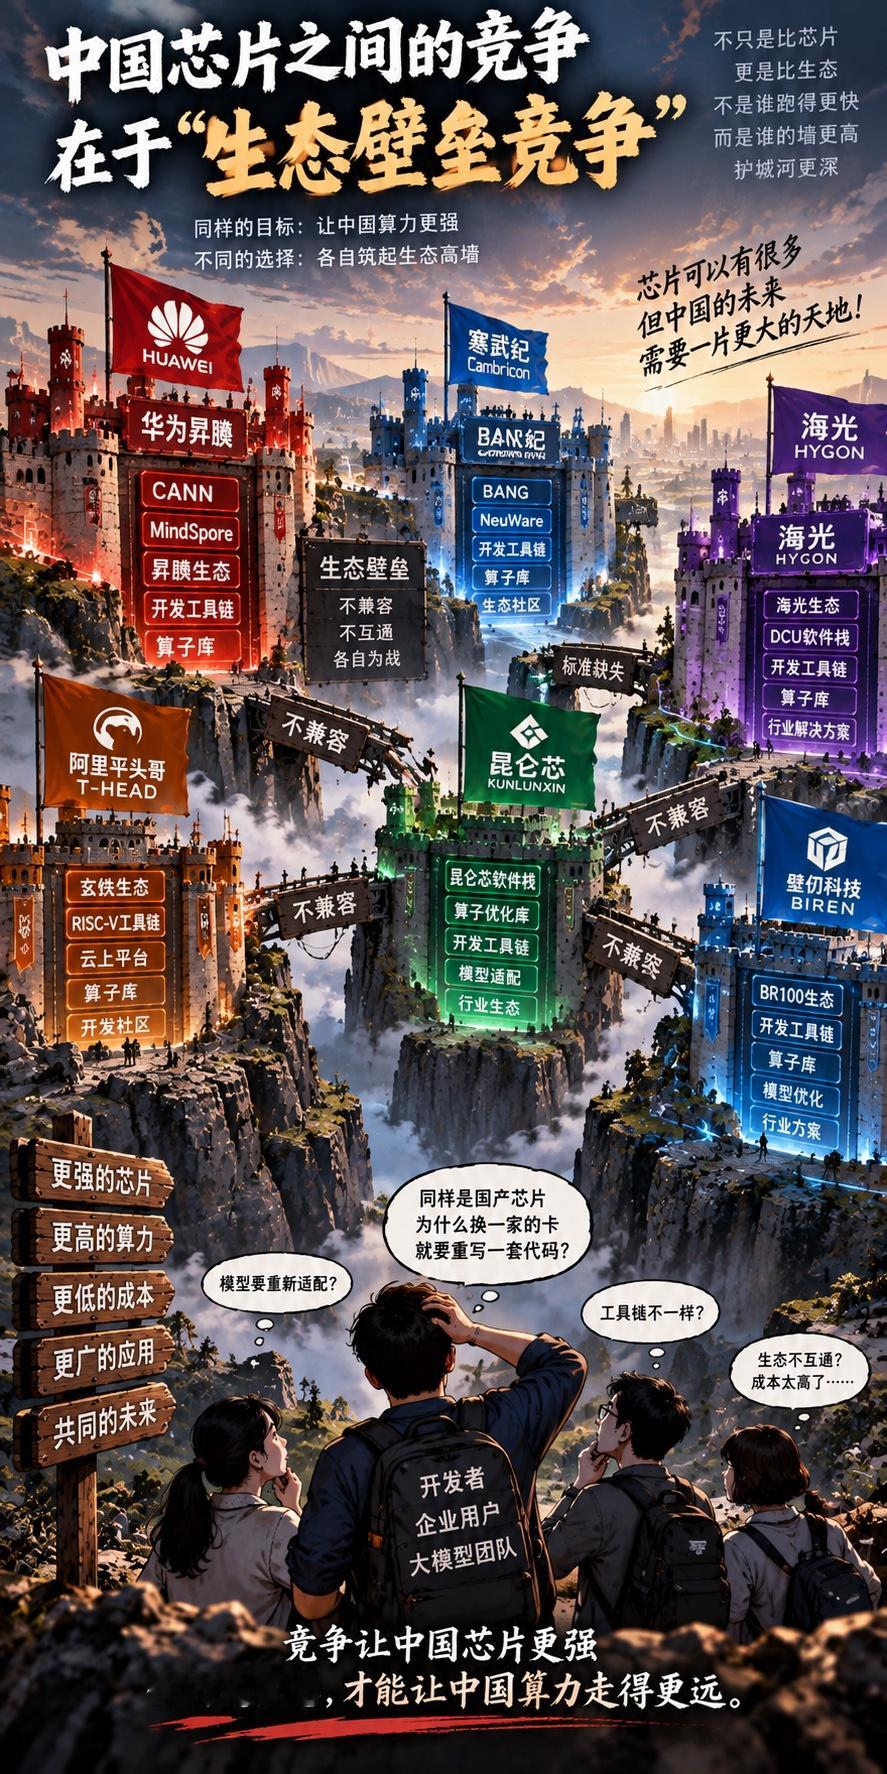
五毛评论|一人一座山头
前面说到中国并不一定缺纸面算力,缺的是把纸面FLOPS稳定兑换成Token的机器。 为什么我认为它能解决?
因为反证已经出现了,而且反证非常强。
智谱最近公开披露,GLM-5.3-Flash在超过10万张国产加速芯片组成的集群上,通过专用推理服务栈、量化、通信和EPD分离调度,把同一套硬件的端到端吞吐做到初始基线的3倍;公司称优化后的硬件利用效率和单Token成本已经达到主流NVIDIA GPU相当水平。这个“相当”目前缺少统一第三方口径,不能无限外推,但至少已经证明性能损失并不是硬件物理上锁死的。 
清微智能和蚂蚁的案例更夸张。双方针对TX8和Qwen长期联合调优后,QPS提高26.7倍,首字延迟下降87.5%,整体推理性能提升超过10倍。这里最值得注意的不是“十倍”本身,而是同一块芯片,经过系统软件优化以后可以出现数量级差异。 
这意味着现在国产算力最缺的东西,其实越来越清楚了:不是更多芯片,而是把这种“高手调出来的奇迹”变成普通客户插上去就能得到的默认性能。
如果每一家模型公司都要派几十个工程师,和每一家芯片厂驻场半年,才能把性能从10%调到70%,那产业仍然没有真正成熟。因为今天有十种卡还能人工调,未来几十种芯片、几千个模型、几十万个企业客户,根本调不过来。
因此真正的终局不能是芯片厂A + 模型厂B → 组队调半年:而必须逐渐变成统一编译层 + 标准算子库 + 通用推理框架 + 标准通信接口 + 自动调优系统 + 异构调度平台。
也就是说,中国需要自己的“CUDA之上的工业基础设施”,但不一定要复制CUDA。反而可能走向一个更开放的异构体系:上面是统一模型接口,中间由编译器和推理引擎做自动适配,下面同时支持海光、华为、寒武纪、昆仑芯、清微等不同架构。
这件事一旦成功,芯片之间的竞争就会从“生态壁垒竞争”更多转向“性能/价格竞争”。
但问题恐怕就是出在生态壁垒这里!