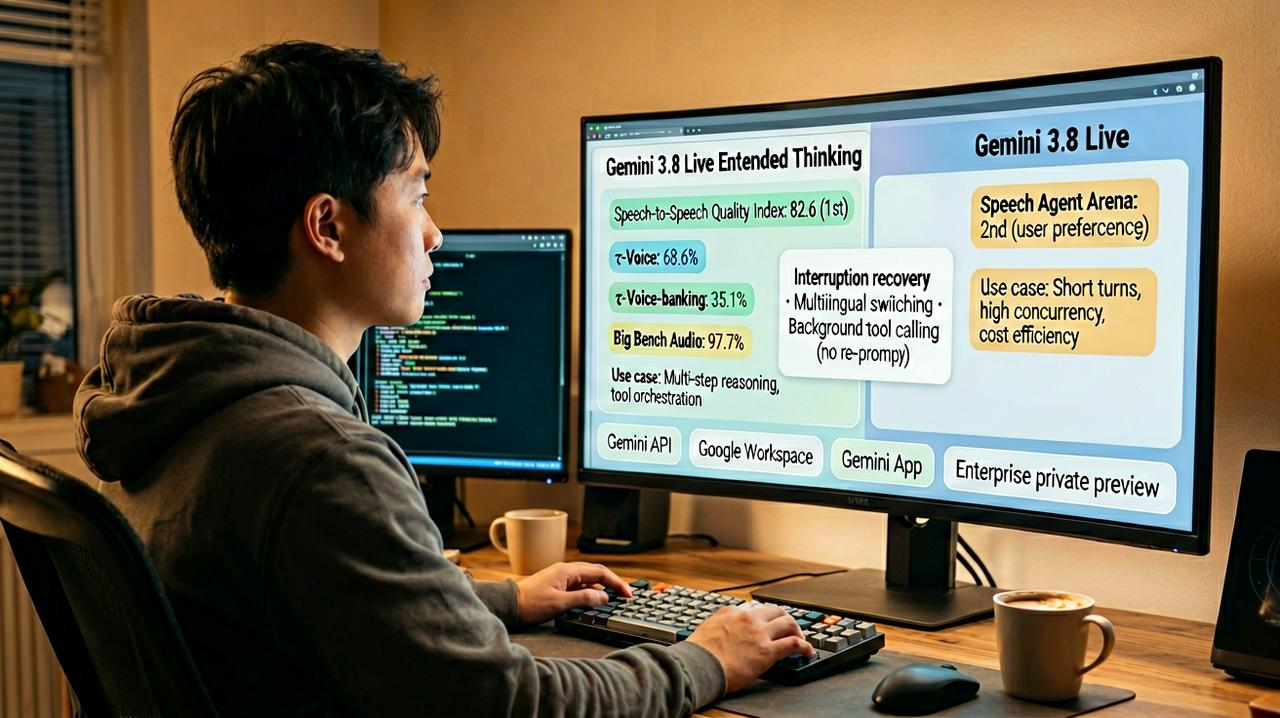
语音 agent 的选型被拆成两条路:Google 同时发两个语音模型,一个拿下对话质量榜第一(82.6 分),一个专跑复杂任务 Google 在 09-15 放出 Gemini 3.8 Live 和 Gemini 3.8 Live Extended Thinking,两条产品线走的是同一个取舍的两端:一个拼规模和成本效率,一个拼复杂任务。
数字这边,Extended Thinking 在 Artificial Analysis 的 Speech-to-Speech Quality Index 上拿到 82.6 分,官方称位列第一;它在 Sierra 的 τ-Voice 基准上 68.6%,τ-Voice-banking 35.1%,Big Bench Audio 97.7%。走规模化路线的 3.8 Live 则在 Speech Agent Arena 的用户偏好榜上排到第二。
变化不只在分数上。官方给的形态是:说话被打断后能接着往下走、跨语言切换、一边对话一边在后台跑工具调用,而不是每问一句就重开一轮。可用范围也摊开了——当天起在 Gemini API、Google Workspace 和 Gemini app 可用,企业侧在 Gemini Enterprise 里先做私有预览。
以上成绩全部来自发布方自己的说法,榜单里 Artificial Analysis 和 Sierra 是第三方,但报哪一个榜、挑哪一栏由发布方决定;Speech Agent Arena 是偏好榜,不等于任务成功率;这次官方博客没给定价,所以「便宜」目前只是一句定位,不是可核对的数字。
我的判断:做实时语音 agent 的团队别按总分选型,先把任务分两类——短回合、高并发、要压成本的走 3.8 Live;要多步推理、要调工具编排的走 Extended Thinking。两类各拿自己的真实对话跑一批,再决定把哪一类放进生产路径。