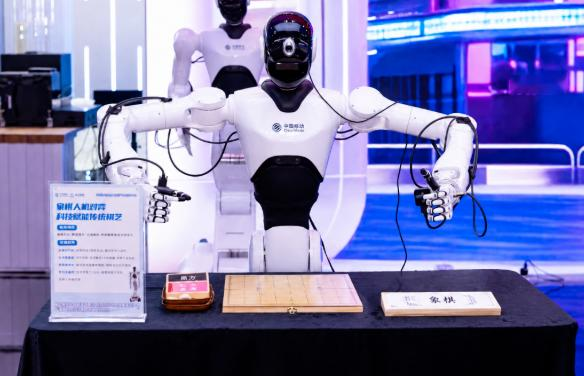
这次轮到中国给全世界“定规矩”了!9月16日,中国移动宣布向全球开源首个机器人通用底座Open-RAIL。以前是别人定标准我们适配,现在是中国开源,全球开发者必须按我们的接口跑。这不是技术慈善,这是阳谋,底层接口一旦统一,美企再怎么卷大模型,也得在我们的轨道上跑。
你知道这件事真正厉害在哪吗?不是那串技术数据,而是它踩准了一个所有人都绕不开的痛点。
机器人这两年的竞争,说白了就是一场“谁的大脑更聪明”的军备赛,英伟达搞虚拟训练场,特斯拉拿汽车供应链压成本,各家都在拼命往模型参数上砸钱。
但有一个问题没有人解决:大脑再聪明,装进机器人之后却不会动。不同品牌的机器人,控制逻辑、通信协议、坐标系方向全不一样,模型推理一次要上百毫秒,控制端却要毫秒级响应.
这中间差了三四十倍的鸿沟,动作卡顿抖动是家常便饭,换一台新机器就得把指令重新翻译一遍,小团队光搭这套管线就要耗掉好几个月。
这才是具身智能落地最脏最累的“最后一公里”,也是最没人愿意去干却绕不开的活。
Open-RAIL做的,就是把这层连接彻底标准化。硬件抽象层把各种机器人的控制接口统一封装,三条并行线程分别处理观测、推理、控制,互不等待,关节加速度标准差从10以上降到0.1,新机器人接入从以周计压到以小时计,新模型最低只要五十到一百行代码。
数据还能在每次真机运行时自动回流,格式开箱即用,端边云随便切换,代码一行不动。
但光说这些数据,还是没说到本质。
真正值得想清楚的问题是:中国移动为什么要开源,而不是做成一个收费的商业平台?
这里有个逻辑很多人没绕过来。开源不是放弃,开源是最聪明的收割方式。底层连接标准一旦被全球开发者接受,每一次真机运行都在往这个生态里回灌数据,每一个接入的机器人团队都在帮这套架构做压力测试和场景验证。
中国移动背后是超百万条具身智能数据集、1200平方米的实体训练场、5G-A网络和遍布全国的边缘算力节点,这些资源才是真正的护城河,开源的底座只是入口。
换句话说,谁掌握了连接标准,谁就在事实上定义了这个行业的工程规则。美国那边至今没有一个统一的连接层,英伟达、OpenAI、特斯拉各走各的路,这恰恰是中国移动下这步棋的时间窗口。
不过,有一个问题同样值得认真对待:开源生态的竞争,从来不只是谁先开源谁就赢。Linux开源了几十年,最终服务器市场格局还是由少数几家云厂商掌控。Open-RAIL现在适配了4款异构机器人、支持10个主流模型,但对标HuggingFace的LeRobot,后者官方支持的硬件型号数量更多,社区活跃度更高,模型生态更广。
先跑不等于跑赢,底座之争的胜负最终取决于开发者社区的规模和数据生态的厚度,这两样东西都需要时间积累,不是一次开源发布能锁定的。
对普通人来说,这件事的意义可能比你想象的更直接。具身智能真正落地的那一天,机器人端咖啡、做巡检、帮老人拿药,背后跑的工程底座是谁家的,决定了谁有定价权、谁掌握数据、谁能持续迭代。
移动星厨机器人已经在杭州移动余杭分工会投入运营,员工可通过饭卡支付享用机器人制作的现磨咖啡,这不是PPT,是已经跑通的闭环。
底座之争,才刚刚开始。你觉得Open-RAIL这步棋,最终能不能把标准真的立起来?