AI训练传数据等太久?中国团队让速度翻了一倍
现在做大模型,都在疯狂堆GPU显卡,但很多人忽略了一个问题:显卡堆得越多,数据传输压力就越大。GPU算力再强,遇上数据排队等待,照样白搭。
近日,ACM SIGCOMM 2026公布论文录用名单,联想研究院与北京大学联合团队参与的EPIC论文成功入选。针对多卡集群的通信瓶颈,联想与北大团队给出了破局思路。联想天禧AI
具体来看,EPIC跳出交换机仅做数据转发的传统定位,让设备在传输途中就完成数据汇总计算,以此减少数据来回传输带来的额外损耗。实测下来,8卡场景下集合通信速度最高提升1.59倍,AI整体训练速度提升38%。联想智能体
放到更大集群里优势更明显:128卡超节点作业时间最高缩短45.8%,2048卡规模下仿真长尾完成时间降低30.9%,同时解决了算力浪费和时延过高两大核心问题。联想混合式AI
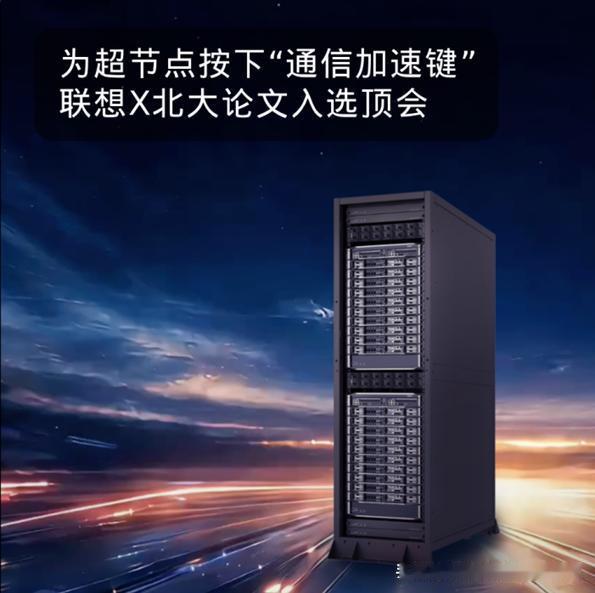
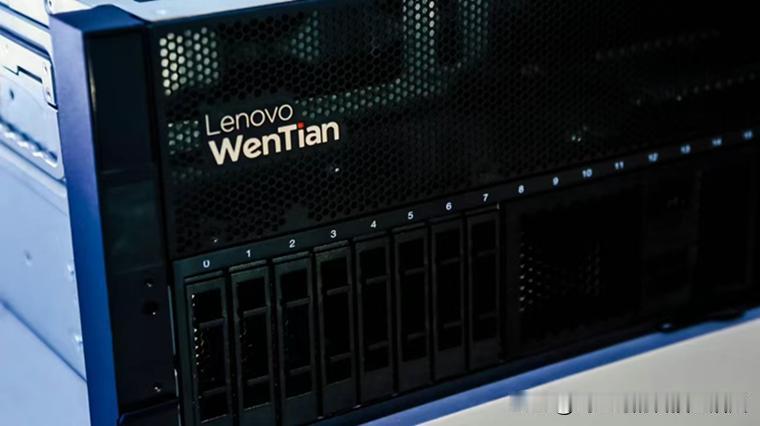
更重要的是,这项研究成果已经在向产品落地推进。今年6月,联想发布的问天超节点算力解决方案,未来可能会接入EPIC协议,把实验室成果转化为实打实的算力能力。
算力卷到尽头,真正的瓶颈可能不是GPU,而是数据怎么传。而联想和北大给出的EPIC论文,就是那个答案。
福利大派送!10月2日前,关注@联想官方账号,转发本文并在评论区说说留下你对联想和北大参与的EPIC论文有什么看法,有机会赢取20元现金红包!抽奖详情