华为昇腾960一、事件核心背景
2026年9月17日华为全联接大会2026,华为正式披露昇腾960 AI芯片完整参数、落地时间表,并全球首发Atlas 960昇腾960超节点,两大重磅产品引爆算力圈热搜。
1. 芯片发布节奏大幅提前:
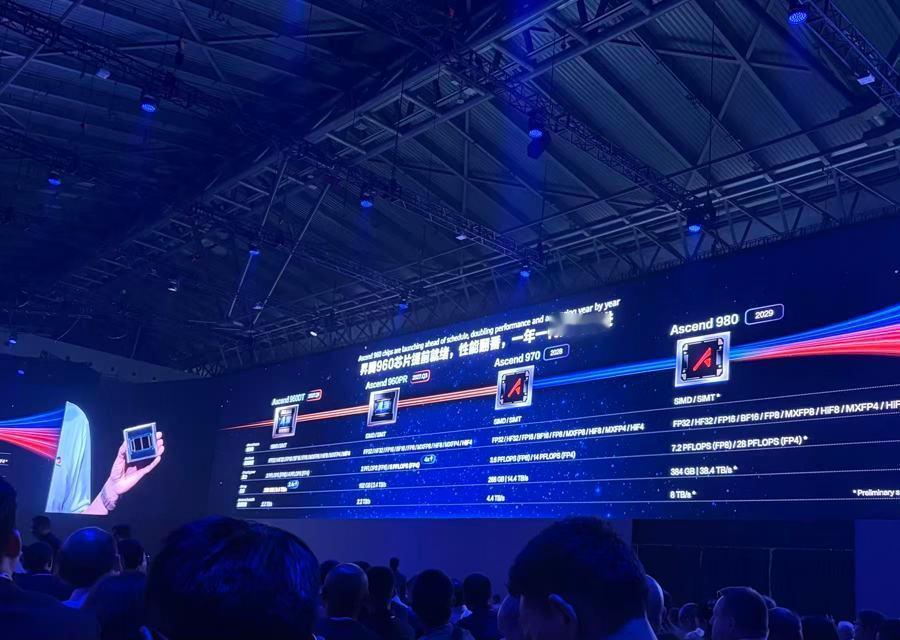
◦ 昇腾960DT(训练主力芯片):原定2027年Q4,提前至2027年一季度上市,提前9个月;
◦ 昇腾960PR(推理专用芯片):2027年三季度落地;
◦ 后续迭代规划:昇腾970(2028)、昇腾980(2029),保持一年一代、算力翻倍节奏。
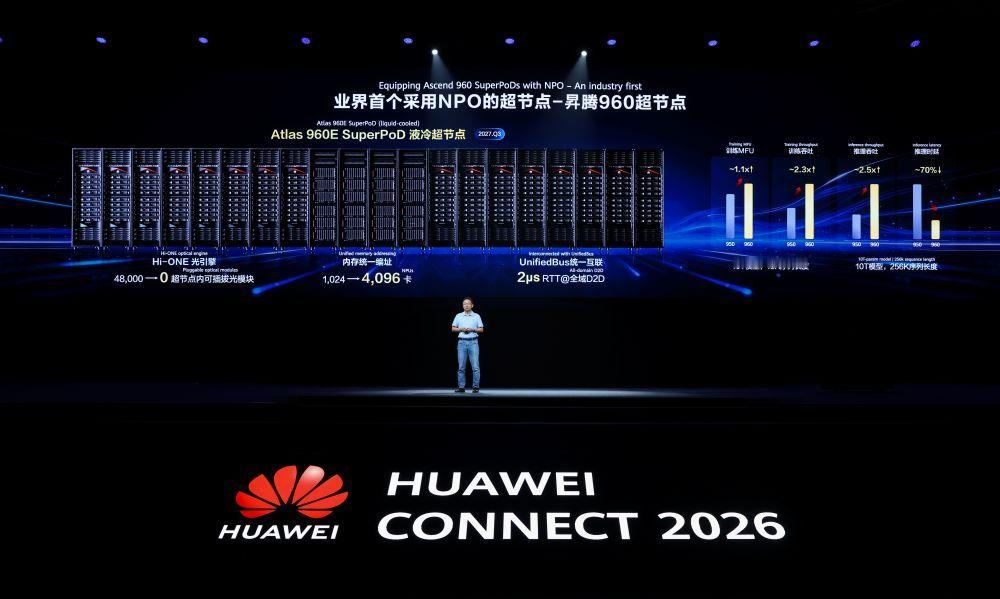
2. 配套超节点:全球首款搭载NPO近封装光学技术的AI超大规模算力集群,专门适配十万亿参数大模型训练、智能体Agent全流程运算。
二、昇腾960芯片核心硬件参数
1. 算力规格FP8峰值算力2 PFLOPS,FP4低精度算力4 PFLOPS,算力较上一代翻倍;完整支持FP32/FP16/BF16/FP8/MXFP4全精度格式,适配大模型训练、推理、多模态视频生成全场景。
2. 内存与带宽单芯片搭载288GB超大HBM高速内存,内存带宽9.6TB/s,大幅缓解千亿级模型显存瓶颈;
3. 核心技术路线:华为自研τ(韬)定律,绕开EUV光刻机,通过芯片架构、封装、软件协同优化实现性能跃升,突破外部制程限制。
三、王牌创新:昇腾960超节点(Atlas 960)核心亮点
1. NPO Hi-ONE光互联,行业技术突破
全球首个量产NPO近封装光引擎Hi-ONE,单引擎传输7.2T;整套超节点用5500颗光引擎替代4.8万颗传统800G光模块,整机功耗降低550kW,设备无故障运行时长翻倍,系统稳定度达99.8%。
2. 超大集群互联能力
单超节点最高支持4096颗昇腾960 NPU高速互联,自研灵衢统一总线架构,跨芯片内存共享,芯片间最低时延仅2微秒;整套集群总FP8算力8EFLOPS(800亿亿次/秒),统一内存池1PB,原生支持十万亿参数超大模型训练。
3. 两种商用形态
• 风冷Atlas 860:2027年Q2,适配普通机房;
• 全液冷Atlas 960:2027年Q3,面向国家级超算、头部AI企业算力中心。
四、核心应用场景
1. 超大基础大模型:万亿、十万亿参数通用大模型预训练、微调;
2. 多模态生成:长视频、3D、文生视频、多模态智能体;
3. 政企算力枢纽:东数西算国家算力中心、金融AI、自动驾驶仿真;
4. 推理集群:高并发对话AI、云端数字人、实时AI检索。
五、全网舆论两大视角
行业乐观向
1. 国产算力里程碑:不依赖海外高端制程、光模块,完整自研芯片+光互联+集群系统全栈方案,补齐国产超大规模算力短板;
2. 打破单芯片内卷:证明AI竞争进入系统架构时代,NPO技术路线开辟国产光互联新赛道;
3. 落地节奏超预期:芯片提前上市,国内互联网、算力企业可快速完成国产化算力替换,缓解算力紧缺。
理性客观讨论向
1. 生态仍需完善:对比海外成熟算力生态,昇腾配套工具链、第三方模型适配仍需持续迭代;
2. 成本待验证:NPO光引擎、液冷超节点初期硬件成本偏高,规模化普及需要产业链降本;
3. 市场竞争加剧:国内外新一代AI芯片集中落地,国产算力进入激烈竞争阶段。
六、产业延伸意义
1. 政策匹配:契合“十五五”算力规划,助力2030年国内智能算力9800EFLOPS目标落地;
2. 产业链带动:拉动HBM内存、光电封装、液冷服务器、高速光通信全产业链国产替代;
3. 战略价值:构建自主可控算力底座,保障国内大模型、人工智能产业安全,摆脱海外算力限制。华为昇腾960