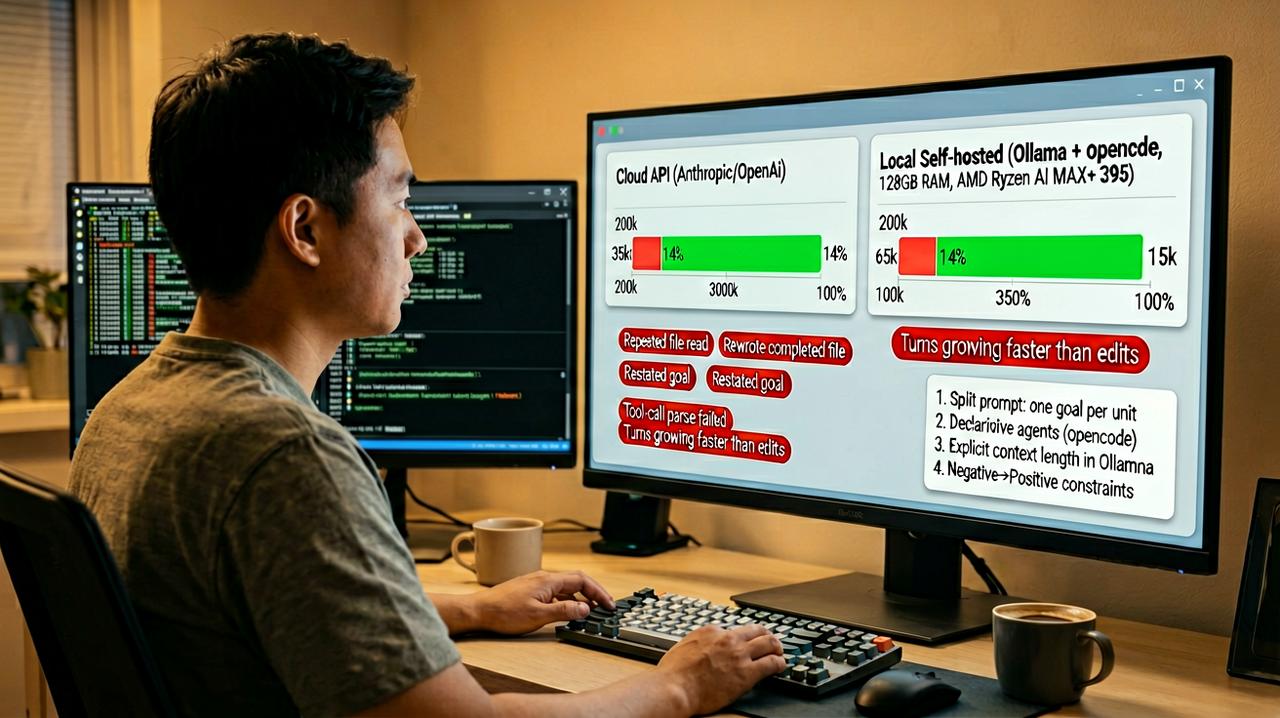
把 35kb 的大提示词搬进本地自托管:上下文只有 65k,一进去就吃掉 14%,三分钟后 agent 开始重复读文件一位做安全方向的研究者,把自己原本跑在 Anthropic / OpenAI 上的一套 agent 搬到了本地:Ollama 加 opencode,机器是 128GB 内存的 AMD Ryzen AI MAX+ 395,32GB 留给系统,其余全给推理。他在 09-11 的笔记里写的不是成功率,而是他踩到的第一堵墙。
他说在他这台机器上,自托管侧的上下文上限是 65k token,一个 35kb 的预置提示词一进去就吃掉 14%;再叠上会话历史,几轮工具调用就填满,有时甚至还没等到第一次回答。之后的行为很有辨识度:重复读同一个文件、重写已经写完的东西、把目标再复述一遍。他的结论不是「本地模型太小」,而是「自托管的窗口太小」——同样的提示词在前沿厂商那边有更大的窗口兜着,写糙了也看不出来,一搬回本地就原形毕露。
他把这种上下文耗尽整理成了可观测信号:连续两次相同工具调用、反复读同一文件、agent 重述目标、tool-call 解析失败、轮次增长远快于文件改动。迁移动作也因此变了样:提示词拆成一个目标一个单元,用 opencode 的声明式 agent 替代「让模型自己去读文件」,在 Ollama 里显式调大 context length,把「不要做 X」改写成正向的「只做 Y」。
这是单人单机的一次记录,不是基准测试;平台是 AMD 而非 Apple Silicon,模型是 27B 级别的去审查版本,数字只对这套配置负责,Mac / MLX 的表现不能直接照搬。
我的判断:自托管省下的是数据外流和 API 账单,代价第一块就落在上下文上。想迁移,先量自己的提示词有多大、再量自托管那侧能开多大窗口,最后才轮到讨论模型够不够聪明。