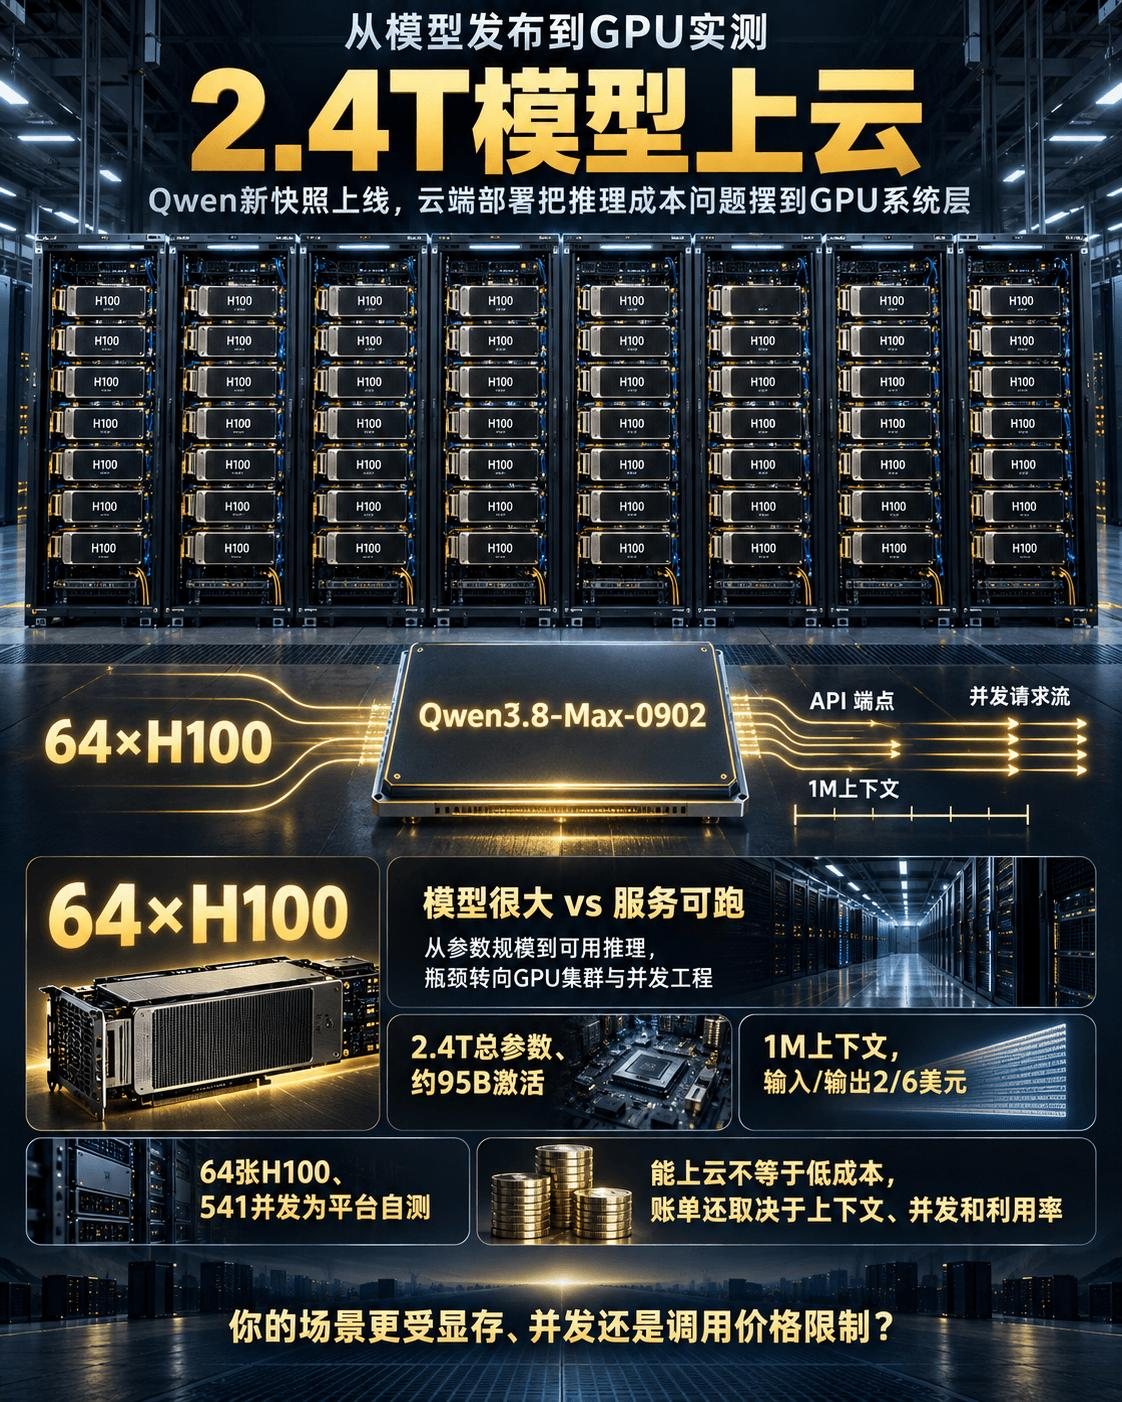
Qwen官方X帖子在9月2日发布Qwen3.8-Max-0902。QwenCloud模型页同日列出:这是一个2.4T总参数、约95B参数激活的MoE模型,支持1M上下文,API价格为输入2美元、输出6美元/百万tokens,缓存价格另计。
这条消息的算力价值,不只是模型更大,而是它把“能不能部署”变成了公开的系统问题。Hyperstack 9月5日发布案例帖称,团队使用64张NVIDIA H100、8个节点部署服务,6分钟内拉起可用端点;随后并发测试达到541个请求,聚合吞吐为81.6 tokens/s。这里的数字属于Hyperstack自己的平台测试,不是独立实验室复现,也不是H100在所有模型和负载下的通用表现。
Arena在9月2日公布的Code Arena WebDev分数为1691,可作为模型能力线索,但不能直接换算成GPU效率。QwenCloud文档也明确,长上下文缓存可以减少重复计算、延迟和成本。
我的判断是:大模型推理的竞争正在从“参数规模”转向“显存、并发、缓存和集群调度”的系统工程。这个判断成立的前提,是实际工作负载具有较长上下文和多请求并发;如果只是短文本、低并发调用,模型标价或单卡速度可能更重要。芯片与算力