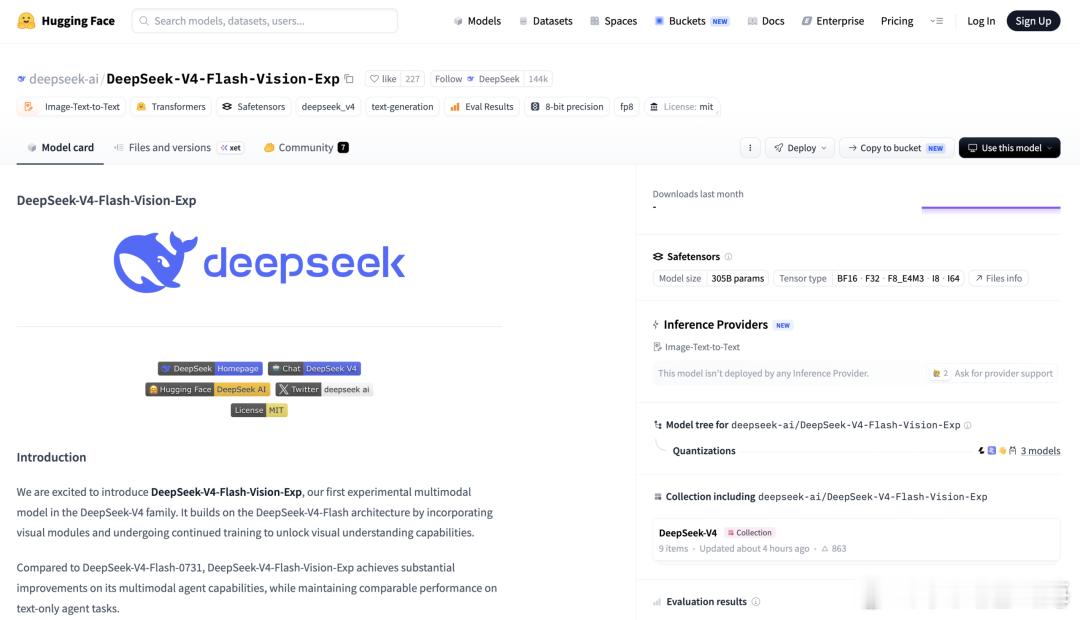
2026 年 8 月 31 日,DeepSeek 正式开源 DeepSeek-V4-Flash-Vision-Exp,这是 DeepSeek V4 系列首款实验性多模态视觉模型。
此前,该模型已于 8 月 21 日率先上线 DeepSeek API 平台,但当时仅提供 API 调用,并未开放模型权重。
目前,DeepSeek 已在 Hugging Face 放出 DeepSeek-V4-Flash-Vision-Exp 模型,采用 MIT License。
包括模型权重、Tokenizer、Prompt Encoding 参考实现以及最小化 PyTorch 推理实现,开发者可以下载模型并进行本地部署和二次开发。
DeepSeek-V4-Flash-Vision-Exp 模型规模约为 305B。基于 DeepSeek-V4-Flash 架构,在原有语言模型基础上加入视觉模块,并通过持续训练获得图像理解能力。
DeepSeek-V4-Flash-Vision-Exp 可以同时处理文字和图片输入,可用于图片理解、截图文字识别、图表分析等任务,也可以结合 Agent 工具完成需要视觉理解的自动化操作。
DeepSeek 表示,在 Agent、推理、世界知识等纯文本能力上,DeepSeek-V4-Flash-Vision-Exp 与 DeepSeek-V4-Flash 基本持平;在需要视觉理解的 Agent Benchmark 上,其性能相比 DeepSeek-V4-Flash 大幅提升,多模态 Agent 能力已经接近 Claude Opus 4.8。